English
 Deutsch
 Français
 Español
Bases de datos de Confluence: guía para usuarios avanzados en 2026
Las bases de datos de Confluence se han convertido discretamente en uno de los elementos básicos más potentes de la plataforma, pero la mayoría de los equipos siguen modelando los datos estructurados en tablas planas, hojas de cálculo adjuntas o incidencias de Jira que nunca se pensaron para eso. Una guía práctica de las bases de datos tal como las usan los usuarios avanzados, con las funciones de 2026, los inconvenientes y los puntos en los que Capable toma el relevo.

Pide a un equipo que use Confluence que te enseñe sus «datos estructurados importantes» y casi siempre obtendrás las mismas tres cosas. Una tabla larga y anquilosada dentro de una página de la wiki, con celdas combinadas que se rompieron hace tres trimestres. Una hoja de Google fijada en la parte superior de la página con una pestaña llamada «actual» que no está al día desde febrero. O un Epic de Jira con ochenta y siete incidencias vinculadas, sin filtros y con una vista que nadie ha abierto en meses.
Ninguno de estos es el lugar para los datos estructurados en Confluence en 2026. Las bases de datos de Confluence sí lo son.
Si no has prestado verdadera atención a las bases de datos desde su lanzamiento, merece la pena volver a mirarlas. Atlassian ha ido publicando mejoras con paciencia durante buena parte de los últimos dieciocho meses, y el conjunto de funciones ha pasado discretamente de «prototipo interesante» a «elemento básico principal del espacio de trabajo». Este artículo es una guía práctica de campo escrita por un equipo que trabaja con ellas a diario.
Qué es realmente una base de datos, en un párrafo
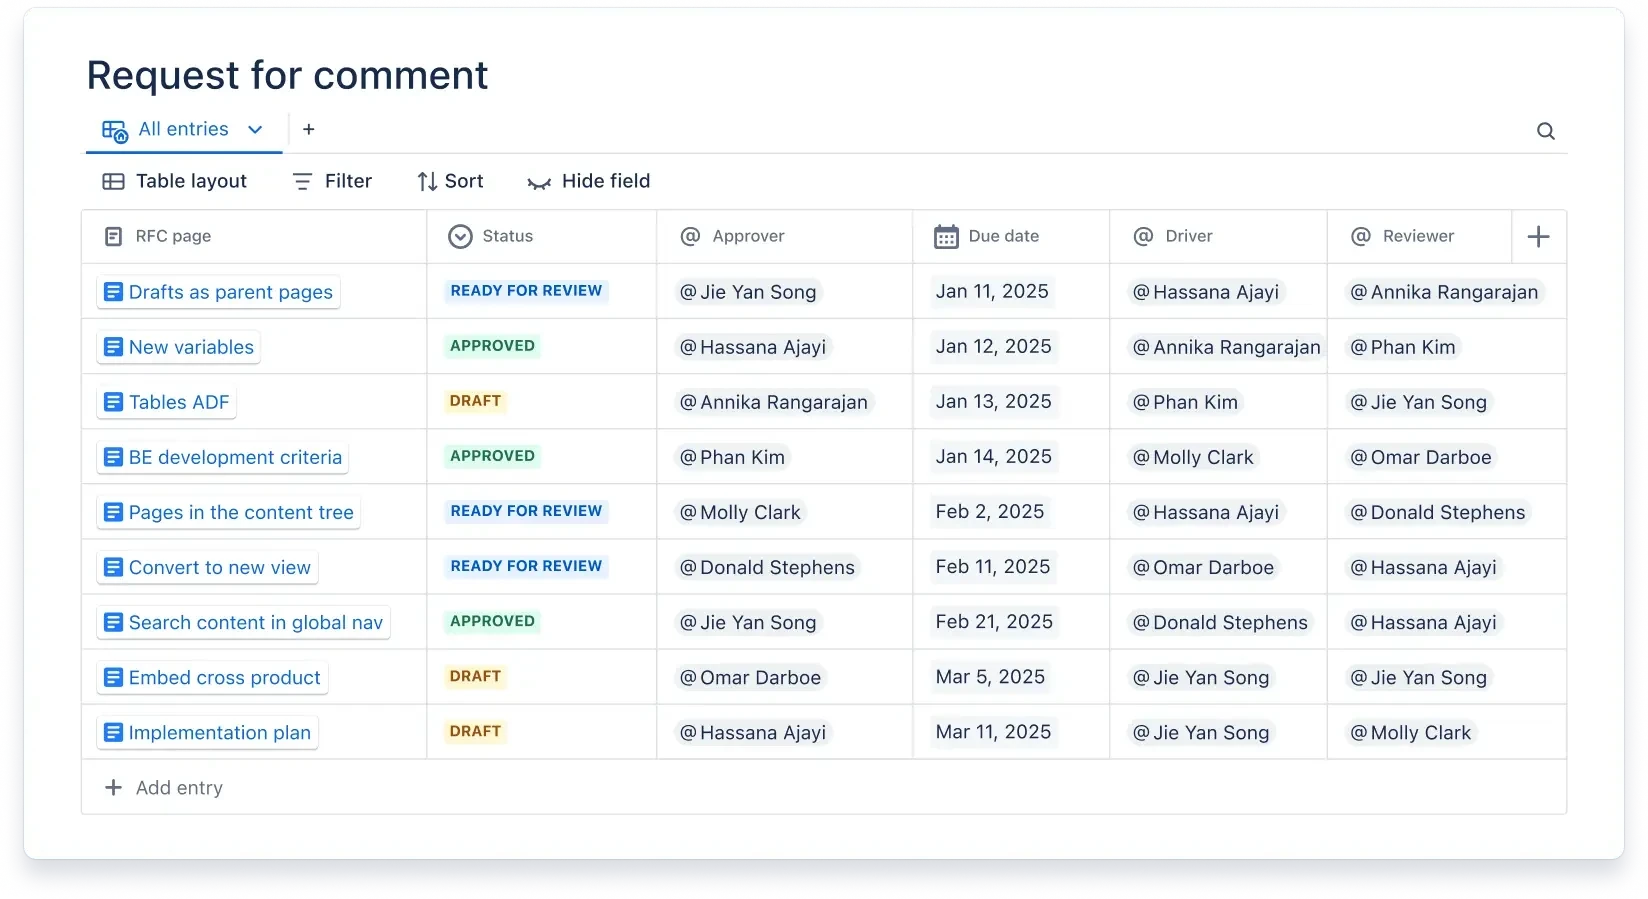
Una base de datos de Confluence es un almacén de datos tipado y consultable que convive con tus páginas. No es una macro. No es un archivo adjunto. Es un objeto de primer nivel en tu árbol de contenido, con su propia URL, sus propios permisos y sus propias vistas. Rellenas filas («entradas»), los campos tienen tipos (texto, número, fecha, selección, selección múltiple, enlace, usuario, incidencia de Jira y una lista creciente de otros) y cualquier vista de los datos se puede insertar allí donde se puede insertar un Smart Link, es decir, casi en cualquier parte.
El modelo mental más cercano es una base de datos de Notion o una base de Airtable, integrada en Confluence en lugar de añadida a posteriori. Esa similitud es intencionada, y ahora es lo bastante profunda como para ser realmente útil.
Dónde las bases de datos superan a las alternativas
Los equipos intentan evitar las bases de datos por dos motivos. El primero es que «ya tenemos una tabla» parece un problema resuelto hasta que necesitas editar los mismos datos en tres sitios. El segundo es que «ya tenemos Jira» parece cubrir el trabajo estructurado hasta que intentas modelar algo que no sea un ticket, un sprint o un epic.
Las bases de datos resuelven ambas quejas, y las resuelven bien.
Para el primer problema, una base de datos sustituye una tabla ligada a una página por un conjunto de datos compartido. Ese conjunto de datos es la versión canónica. Las vistas que se crean sobre él son proyecciones. Si tu página de estado del proyecto, tu dashboard de operaciones y tu correo semanal necesitan ver los mismos riesgos filtrados y ordenados de forma distinta, todos apuntan a la misma base de datos y muestran una vista diferente. Cambia la fila subyacente una vez y se actualizarán todas las vistas que la contengan.
Para el segundo problema, una base de datos maneja con soltura cosas para las que Jira nunca se diseñó. Registros de proveedores. Inteligencia competitiva. Procesos de contratación. Registros de evidencias de cumplimiento. Seguimiento de eventos. Calendarios de contenido. Recetarios de SOP, donde cada fila es un procedimiento con su runbook vinculado. Jira es excelente para incidencias, pero muchísimos datos operativos no son incidencias, y muchos acaban por defecto en hojas de cálculo simplemente porque nadie quería crear una herramienta nueva.
Las funciones que los equipos no saben que tienen
Un recorrido práctico, ordenado más o menos según la frecuencia con la que resultan útiles.
Varias vistas sobre los mismos datos. Una misma base de datos puede mostrarse como tabla, tablero (estilo Kanban), cuadrícula de tarjetas o galería. Cada vista tiene sus propios filtros, ordenaciones y campos visibles. La vista de tabla para la gestión de proyectos, la vista de tablero para las mismas filas agrupadas por estado, la vista de tarjetas para las mismas filas filtradas por «en revisión», y todas apuntan a un único conjunto de datos. Esta es la función que cambia discretamente cómo vive el contenido estructurado en Confluence. En lugar de un informe y una carpeta de capturas copiadas y pegadas, tienes una sola fuente y muchas superficies.
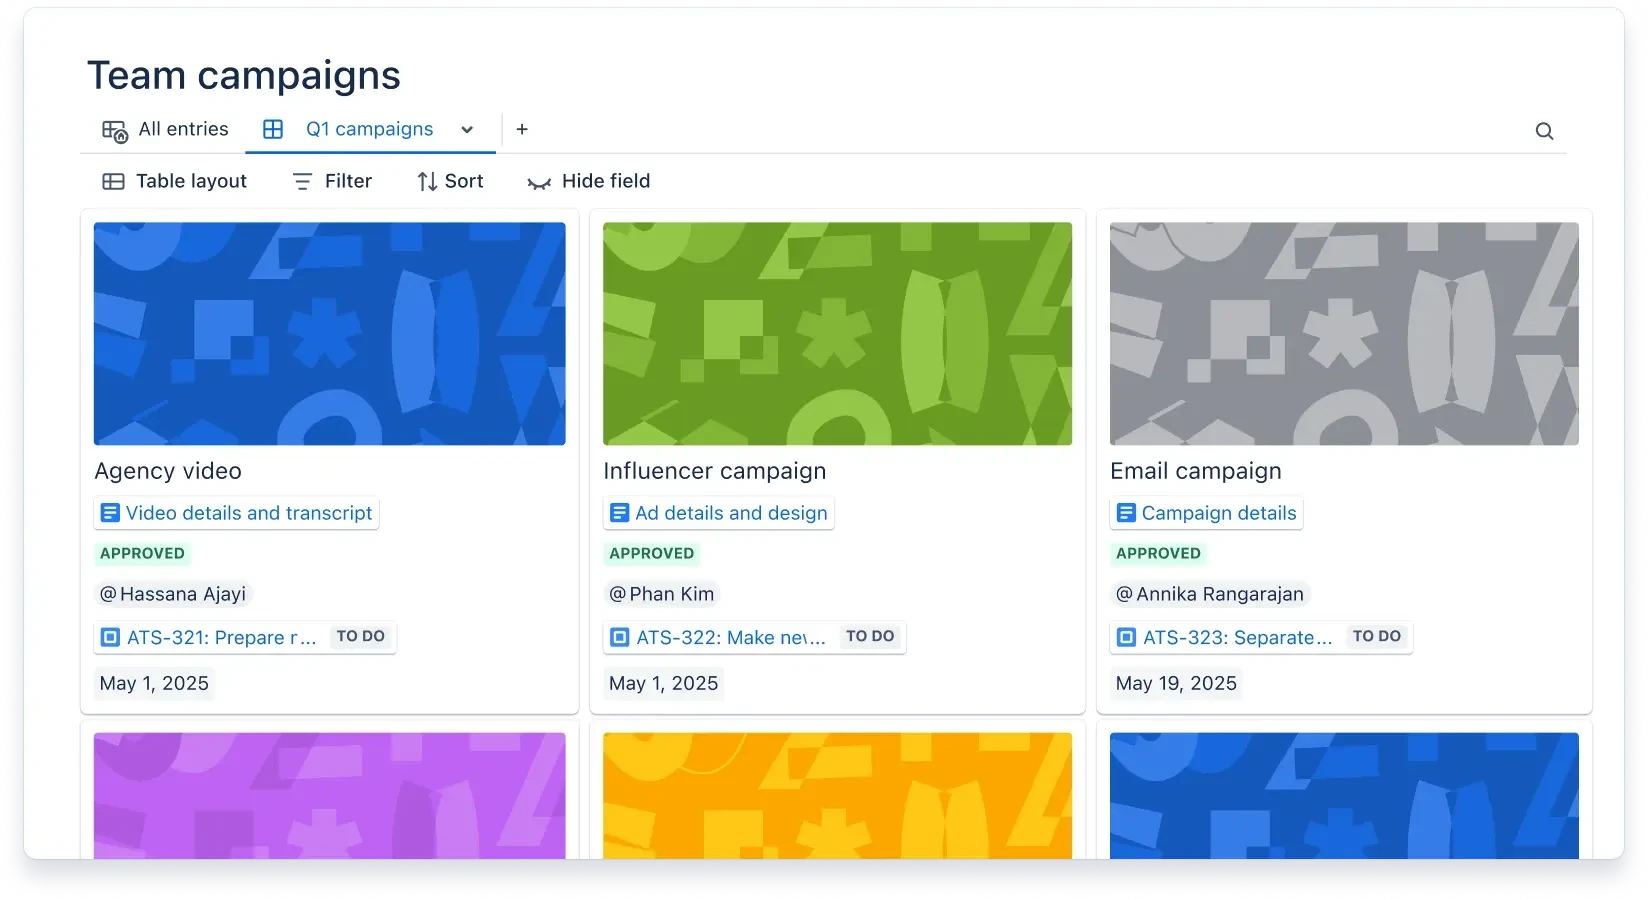
Smart Links dentro de los campos. Un campo de enlace en una base de datos no se muestra como una URL azul. Se muestra como un Smart Link, lo que significa que una incidencia de Jira aparece como una etiqueta con tipo y estado, un archivo de Figma como una miniatura, un vídeo de Loom como un botón de reproducción y un Google Doc como una tarjeta de vista previa. Las bases de datos se convierten en un centro de contenido entre herramientas de una forma que una tabla normal nunca podrá. Una fila de proyecto puede incluir su epic de Jira, su archivo de diseño, su página de especificación, su tablero de retrospectiva y su grabación de la demo en cinco campos limpios.
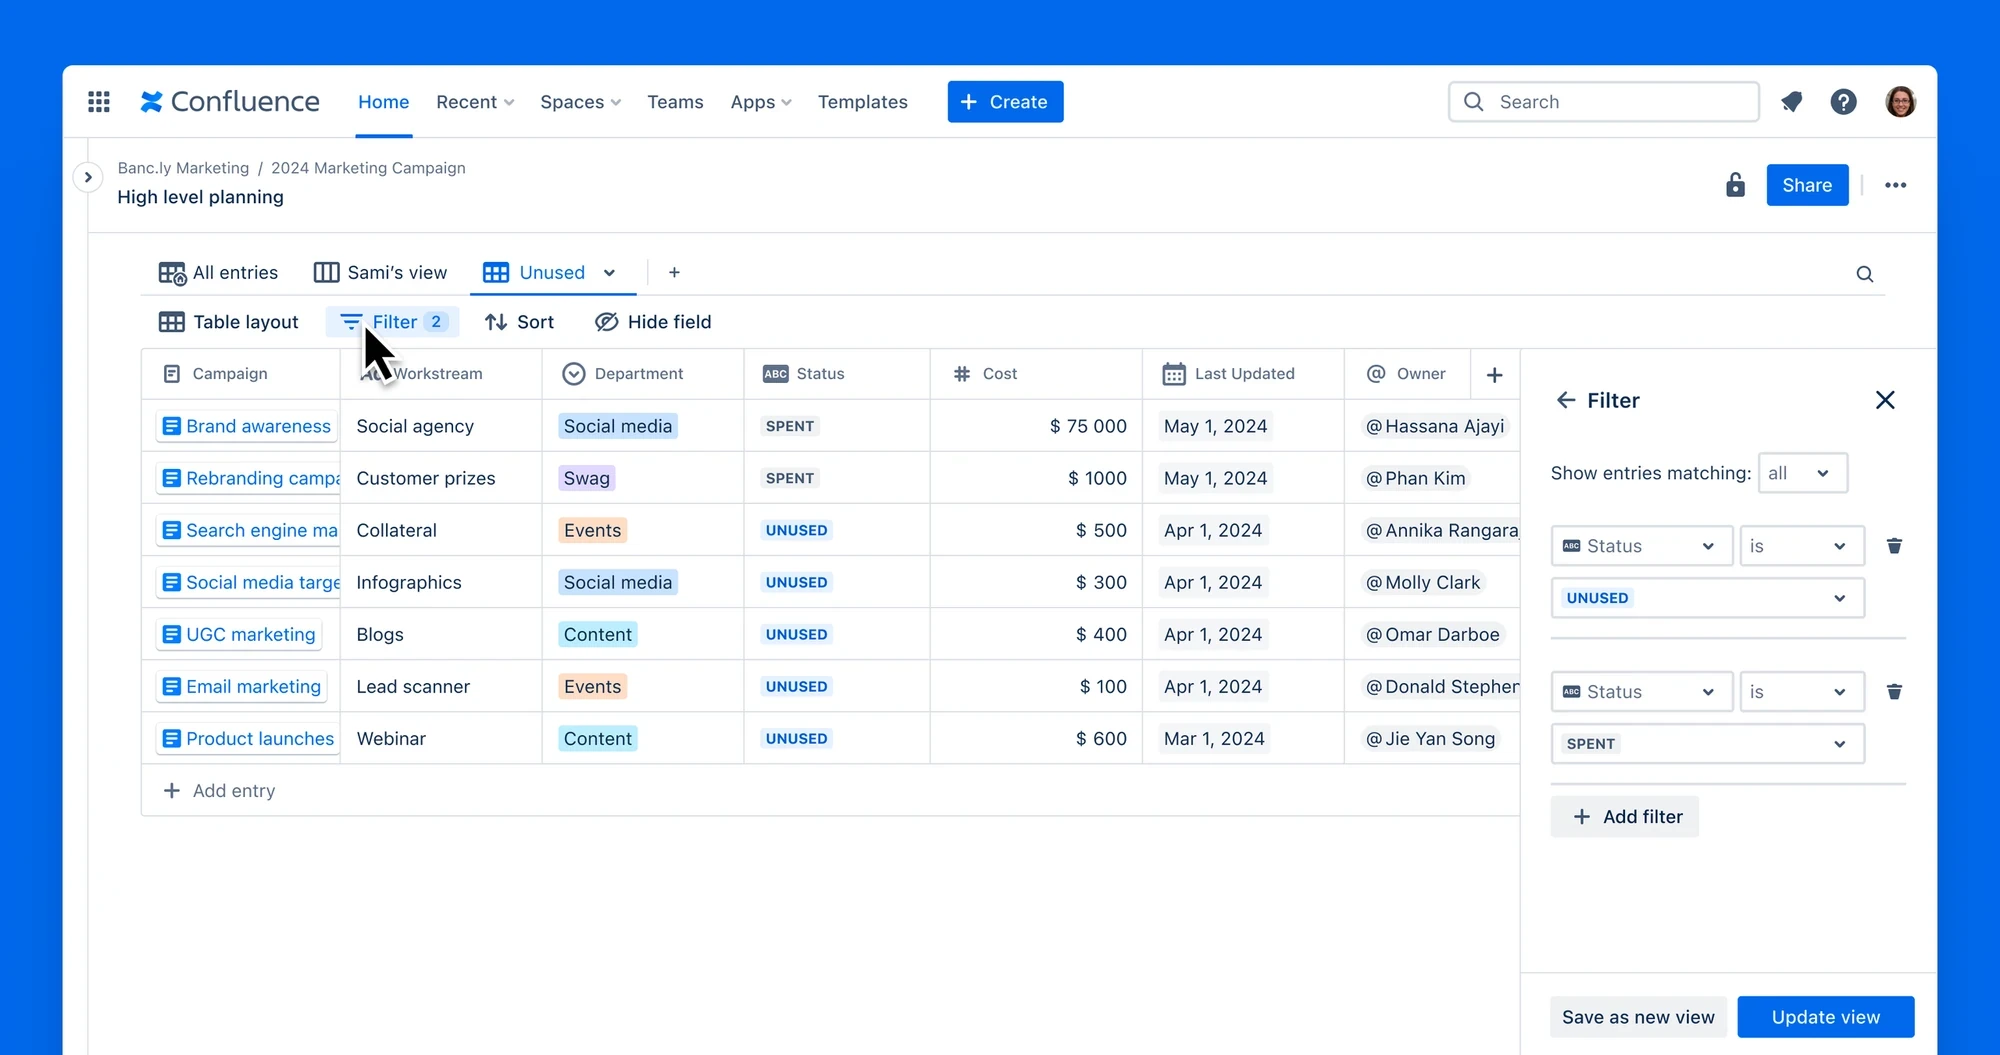
Filtrado con lógica, no solo con palabras clave. Cualquier campo puede usarse para filtrar una vista, incluidos filtros compuestos con lógica AND/OR, y puedes guardar esos filtros como vistas con nombre. «Riesgos asignados a mí, abiertos en los últimos treinta días, con estado distinto de Done» es una vista. «Funciones previstas para la próxima versión, en todos los equipos» es otra. Creas una vista una vez, compartes su enlace y quienes se incorporan ven de inmediato el mismo recorte que tú.
Inserta una vista en cualquier lugar. Una vista de base de datos tiene su propia URL, y esa URL funciona como un Smart Link. Puedes pegarla en una página de Confluence, en otra base de datos, en la descripción de un ticket de Jira o en un mensaje de Slack. La inserción está en vivo. Quienes leen la página ven los datos actuales, no una captura que quedó obsoleta en el momento en que la hiciste.
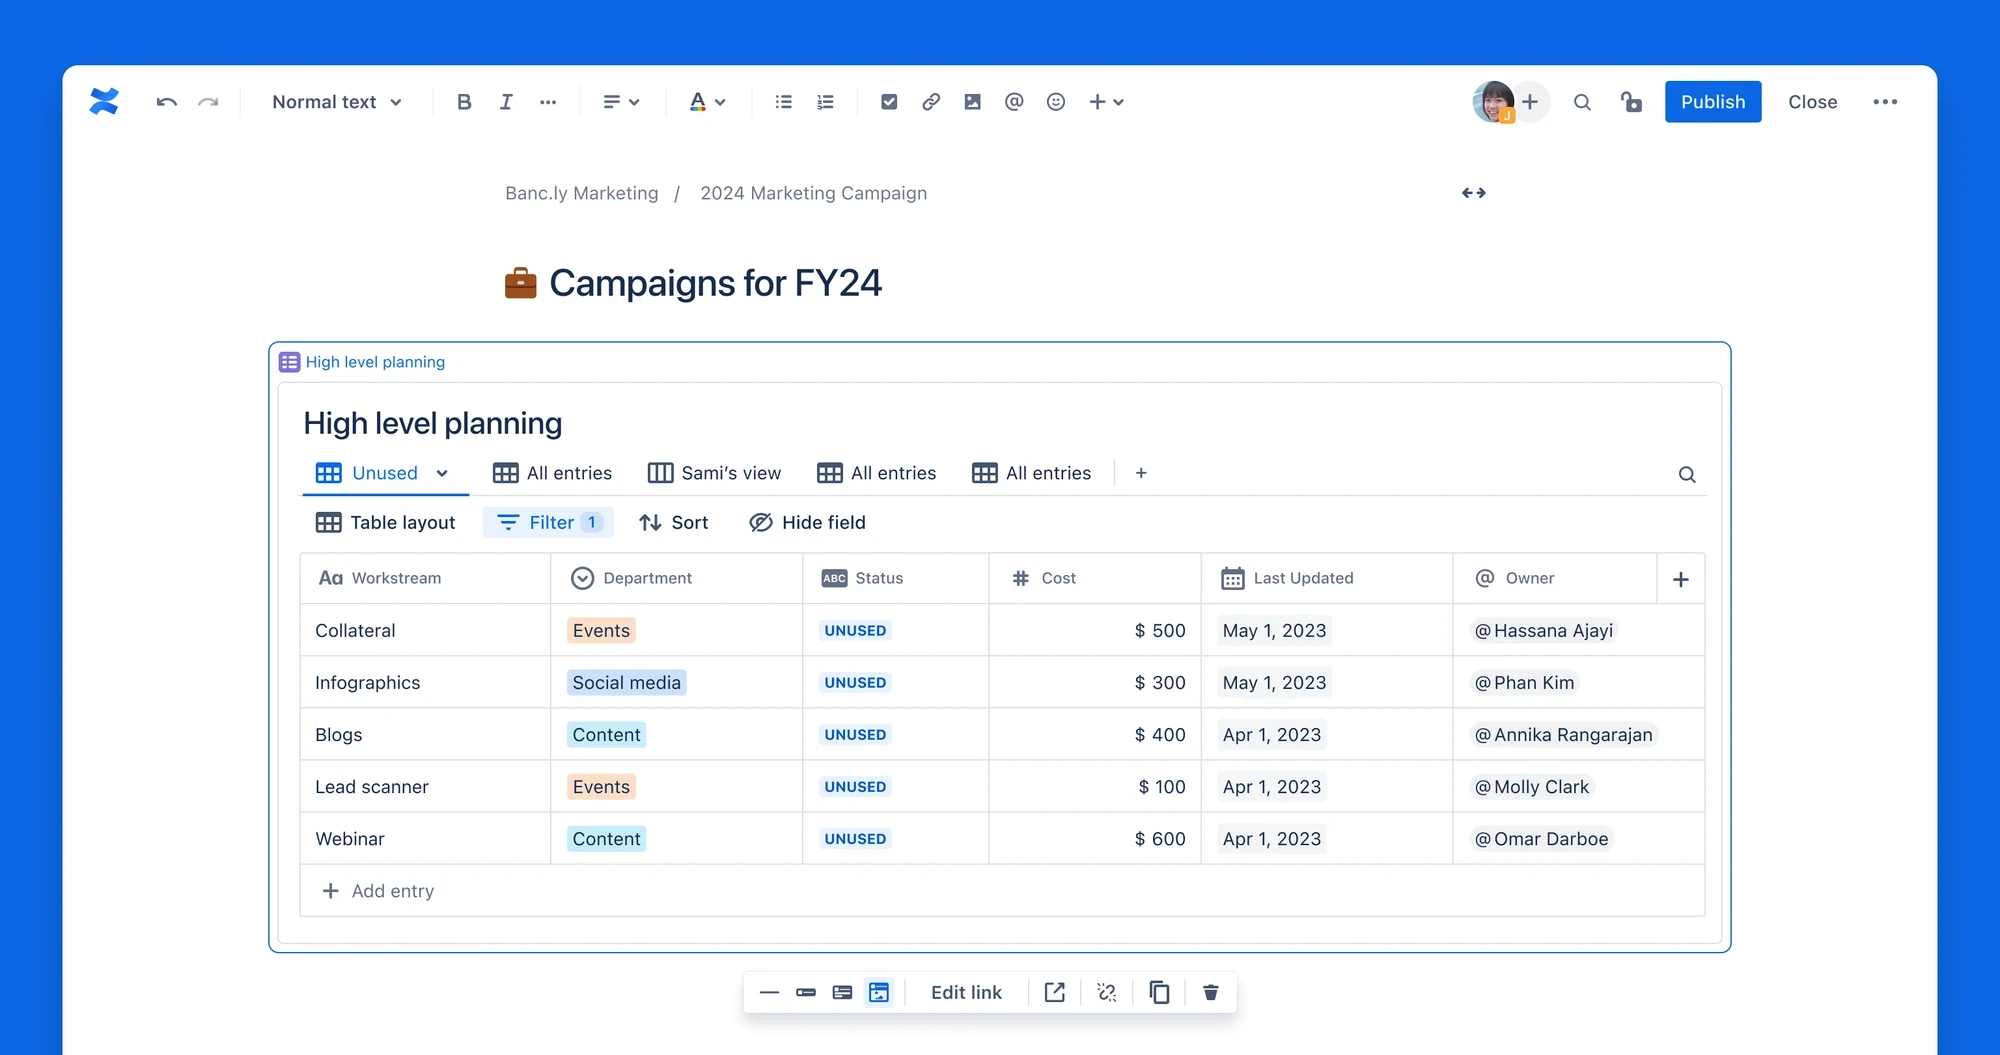
Edición en línea desde cualquier superficie. Puedes editar una fila desde la propia inserción, sin salir de la página. Para la mayoría de los equipos, el mayor cambio de comportamiento es que la página de «datos estructurados» deja de ser un dashboard de solo lectura y pasa a ser una superficie de trabajo. El estado se actualiza en la misma página en la que se informa.
Lo que las bases de datos no son (todavía)
No son una hoja de cálculo. No hay fórmulas de celda, ni SUMIF, ni tablas dinámicas. Si tu flujo de trabajo consiste en «calcular una puntuación ponderada sobre quince filas y representarla en un gráfico», chocarás enseguida con sus límites.
No tienen permisos a nivel de fila. Las bases de datos heredan los permisos del espacio. Una base de datos en un espacio público es una base de datos pública. Por defecto, no puedes mostrar a Marketing un conjunto de filas y a Finanzas otro. Es una carencia real en entornos regulados, y es el principal motivo por el que algunos equipos siguen usando hojas de cálculo para los datos sensibles.
Rovo todavía no las indexa por completo. A fecha de abril de 2026, la búsqueda de Rovo puede mostrar bases de datos como objetos, pero el contenido de sus entradas no siempre aparece cuando le haces una pregunta a Rovo sobre todo tu espacio de trabajo. Atlassian ha ido publicando mejoras de forma constante y la brecha se está reduciendo, pero conviene saberlo si tu equipo usa Rovo como capa de búsqueda universal. Un pequeño truco: mantén una página de resumen por cada base de datos, redactada en prosa, para que Rovo tenga algo que devolver cuando alguien pregunte por su contenido.
No caducan, ni se archivan, ni se aprueban solas. Una entrada de base de datos dura para siempre a menos que alguien la elimine. Parece bien hasta que tu registro de proveedores tiene cuatrocientas entradas, la mitad de ellas de organizaciones que dejaron de existir en 2023. Las bases de datos te dan almacenamiento estructurado. No te dan gobernanza. Combínalas con reglas de automatización donde puedas, y con aprobaciones formales donde debas.
Cinco patrones que vale la pena copiar
Formas concretas en que los equipos de alto rendimiento usan las bases de datos y que merece la pena adoptar hoy mismo.
El registro de decisiones. Una fila por decisión, con campos para la decisión, la fecha, el responsable, el contexto, la página de propuesta vinculada y las notas de reunión vinculadas. Una vista filtrada por equipo sirve para la incorporación. Una vista filtrada por «últimos noventa días» sirve para la revisión mensual. En dos años, la base de datos se convierte en el activo individual más valioso del equipo, y vale la pena decirlo en voz alta: la mayoría de las decisiones que se toman en la mayoría de las empresas se pierden en menos de un año, y un registro de decisiones es el artefacto de mayor impacto que la mayoría de los equipos nunca crea.
El seguimiento de competidores. Una fila por competidor, con campos para segmento, posicionamiento, nivel de precios, lanzamientos recientes (selección múltiple), documentos de análisis vinculados e información de ventas vinculada. Producto y marketing ven la misma vista. Sales enablement recibe una vista filtrada. Las actualizaciones se hacen en un solo lugar. Tu inteligencia competitiva deja de ser cinco hojas de cálculo distintas en manos de cinco personas distintas.
El registro de evidencias para cumplimiento. Una fila por control, con campos para el marco (SOC 2, ISO 27001, FDA), última revisión, responsable, documento de evidencia vinculado y fecha de la próxima revisión. Un tablero agrupado por marco. Una vista filtrada de «controles revisados en los últimos noventa días» guía la reunión con el auditor.
Esa última salvedad merece destacarse. Las bases de datos son excelentes para hacer seguimiento de información estructurada. No están pensadas para la capa de gobernanza que va por encima. En Capable lo vemos con frecuencia: los equipos crean un registro de evidencias impecable en una base de datos y luego se dan cuenta de que necesitan aprobaciones aptas para auditoría, caducidad y umbrales de revisores sobre las entradas. Ahí es donde encaja Capable Approval, junto a la base de datos en lugar de competir con ella. Las bases de datos almacenan los datos. Capable Approval gobierna la aprobación. Juntas te dan algo que un auditor realmente aceptará.
Optimizaciones del flujo de trabajo para aplicar esta semana
Tres acciones concretas, de menor a mayor esfuerzo.
Una. Elige una tabla que todo el mundo copia y pega. Todos los equipos tienen una. Sustitúyela por una base de datos. Elige tres campos que deberían tener tipo, añádelos y reconstruye la tabla como vista de base de datos. La ventaja inmediata es que la próxima persona que necesite actualizar los datos lo hará en un solo lugar.
Dos. Añade una segunda vista a esa base de datos. Si la primera vista es una tabla, haz que la segunda sea un tablero. Si la primera es un tablero, haz que la segunda sea una tabla filtrada por la semana actual. No te creerás lo rápido que la gente empieza a pedir la tercera vista.
Tres. Referencia una base de datos desde una página. Inserta una vista concreta en la página de resumen del proyecto, filtrada por las filas relevantes para esa página. Esa sola acción convierte una página de resumen estática en una página de estado en vivo, y convierte la base de datos de «algo que está por ahí» en «aquello en lo que trabajas cada día». Una vez que eso ocurre, la gente le añade datos de forma natural, porque es donde realmente tienen que estar.
Donde las bases de datos se encuentran con Capable
Seamos sinceros. Las bases de datos son buenas para el almacenamiento estructurado, los campos con tipo, las vistas filtradas y la inserción de datos en vivo allí donde se leen. No son una capa de gobernanza, ni una capa de publicación, ni un gestor de recursos visuales, y no modelan todo lo que aparece en el trabajo operativo real.
Dónde terminan las bases de datos y empieza Capable.
Aprobaciones y auditoría. Capable Approval se encarga de la capa de aprobación, caducidad y registro de auditoría que las bases de datos no cubren. Una fila de base de datos marcada como «aprobada» es un campo de texto libre. Un evento de aprobación en Capable es un registro firmado, registrado y a prueba de manipulaciones, con umbrales de revisores y reglas de caducidad. Los equipos sujetos a SOC 2, ISO o marcos regulados necesitan lo segundo.
Gestión de recursos visuales. Las bases de datos pueden referenciar imágenes mediante Smart Link, pero no son una biblioteca de imágenes. Si tu equipo mantiene cientos de capturas, logotipos y diagramas que deben reutilizarse en varias páginas, versionarse, anotarse y sustituirse en un solo lugar, Capable Image Library es la herramienta adecuada, y funciona de forma natural junto a las bases de datos en lugar de intentar sustituirlas.
Calendarios de lanzamientos y publicación. Las bases de datos ofrecen vistas de calendario. No coordinan el ciclo real de lanzamiento, el embargo, la congelación de contenido ni la cola de publicación. Capable Calendar encaja aquí: ofrece a los equipos un calendario compartido que trata los lanzamientos, la publicación y los eventos como objetos de primer nivel, con sus propios permisos y notificaciones.
Diagramas que no son diagramas de flujo. Una referencia a un archivo de diagrama dentro de una fila de base de datos está bien. Crear diagramas de arquitectura serios, modelos C4, BPMN o UML no es un problema de bases de datos. Para eso, Capable Diagrams trabaja junto a la base de datos.
Publicación fuera de Confluence. Una vista de base de datos sigue siendo un objeto de Confluence. Si los datos tienen que llegar a un portal de clientes, un sitio de partners o una base de conocimiento pública, Capable Publisher (y Capable Sites) se encargan de esa superficie externa.
Dicho de la forma más breve: Confluence Databases es una mejora real en el almacenamiento y las consultas de la plataforma. Capable es la capa operativa que las rodea: la gobernanza, los recursos visuales, la planificación, la publicación externa y las herramientas especializadas que las bases de datos nunca pretendieron ser.
La idea de fondo
Lo que separa a un equipo que domina Confluence de uno que simplemente lo usa no es la cantidad de funciones que conoce, sino los elementos básicos que elige. Un equipo que recurre a páginas con tablas para todo trabaja en contra de la plataforma. Un equipo que recurre a páginas, bases de datos, bloques sincronizados, pizarras y Smart Links según la forma de lo que está modelando trabaja a favor de ella.
Vale la pena aprender a usar las bases de datos porque abren la puerta a un Confluence completamente distinto. Uno en el que los datos estructurados son de primer nivel, las vistas son baratas y la versión canónica de cualquier conjunto de datos vive exactamente en un solo lugar. La recompensa no aparece en una función concreta, sino en la desaparición gradual de todas esas pequeñas formas en que el conocimiento de tu equipo solía dispersarse.
Si llevas tiempo queriendo probar las bases de datos en serio y nunca encontraste el momento, esta es la semana. Elige la tabla más copiada de tu espacio de trabajo. Muévela. Observa lo que pasa.
👉 Consulta la documentación completa de Confluence Databases