English
 Deutsch
 Français
 Español
Bases de données Confluence : le guide des utilisateurs avancés 2026
Les bases de données Confluence sont discrètement devenues l'une des briques les plus puissantes de la plateforme. Pourtant, la plupart des équipes modélisent encore leurs données structurées dans des tableaux plats, des feuilles de calcul en pièce jointe ou des tickets Jira qui n'ont jamais été conçus pour cela. Voici un guide pratique des bases de données telles que les utilisateurs avancés s'en servent réellement : les fonctionnalités de 2026, les pièges à éviter et les points où Capable prend le relais.

Demandez à une équipe qui utilise Confluence de vous montrer ses « données structurées importantes » et vous obtiendrez presque toujours les trois mêmes choses. Un long tableau figé dans une page wiki, avec des cellules fusionnées qui ne fonctionnent plus depuis trois trimestres. Une feuille Google Sheets épinglée en haut de la page, avec un onglet « actuel » qui n'est plus à jour depuis février. Ou un Epic Jira avec quatre-vingt-sept tickets liés, sans aucun filtrage, et une vue que personne n'a ouverte depuis des mois.
En 2026, aucune de ces solutions n'est le bon endroit pour stocker des données structurées dans Confluence. Les bases de données Confluence, si.
Si vous ne vous êtes pas vraiment penché sur les bases de données depuis leur lancement, elles méritent un nouveau coup d'œil. Atlassian les fait évoluer patiemment depuis la majeure partie des dix-huit derniers mois, et leurs fonctionnalités ont discrètement franchi le cap entre « prototype intéressant » et « brique fondamentale de l'espace de travail ». Cet article est un guide de terrain rédigé par une équipe qui s'appuie sur elles au quotidien.
Ce qu'est vraiment une base de données, en un paragraphe
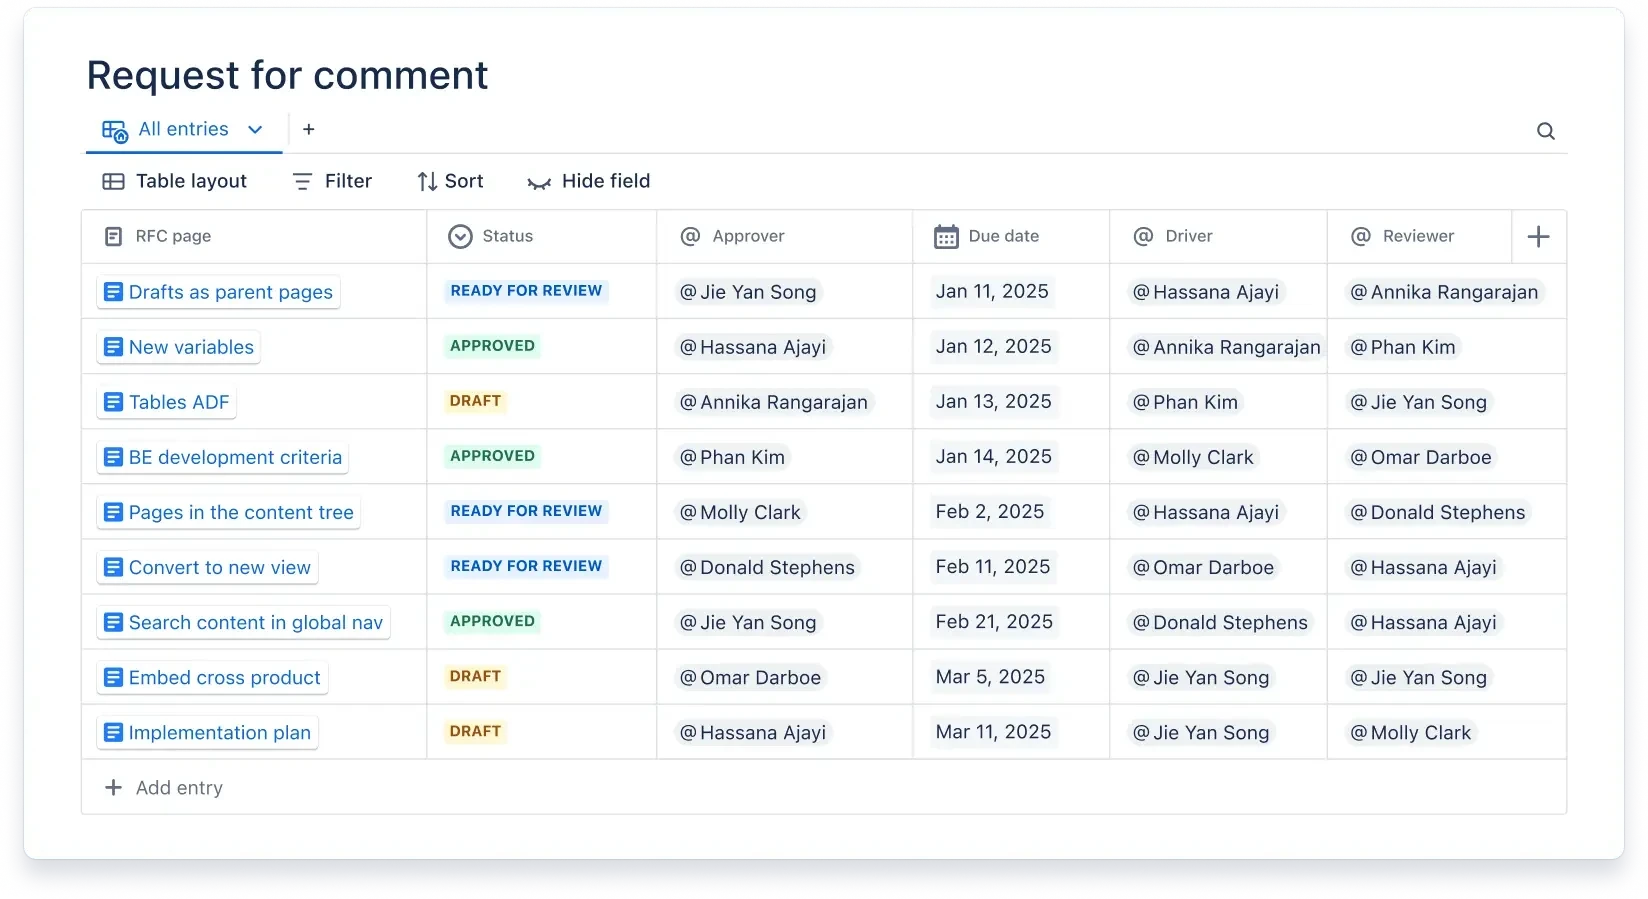
Une base de données Confluence est un espace de stockage de données typées et interrogeables, qui vit à côté de vos pages. Ce n'est pas une macro. Ce n'est pas un fichier joint. C'est un objet à part entière de votre arborescence de contenu, avec sa propre URL, ses propres autorisations et ses propres vues. Vous y ajoutez des lignes (des « entrées »), les champs sont typés (texte, nombre, date, sélection, sélection multiple, lien, utilisateur, ticket Jira et une liste d'autres types qui ne cesse de s'allonger), et n'importe quelle vue des données peut être intégrée partout où un Smart Link peut l'être, c'est-à-dire presque partout.
Le modèle mental le plus proche est celui d'une base de données Notion ou d'une base Airtable, intégrée nativement à Confluence plutôt que greffée dessus. Cette ressemblance est voulue, et elle est désormais suffisamment poussée pour être réellement utile.
Là où les bases de données surpassent les alternatives
Les équipes évitent les bases de données pour deux raisons. La première : « nous avons déjà un tableau » semble régler le problème, jusqu'au jour où il faut modifier les mêmes données à trois endroits. La seconde : « nous avons déjà Jira » semble couvrir le travail structuré, jusqu'au moment où l'on essaie de modéliser autre chose qu'un ticket, un sprint ou un epic.
Les bases de données répondent à ces deux objections, et elles y répondent bien.
Pour le premier problème, une base de données remplace un tableau lié à une page par un jeu de données partagé. Le jeu de données fait référence. Les vues construites par-dessus en sont des projections. Si votre page de statut de projet, votre dashboard opérationnel et votre e-mail hebdomadaire doivent tous afficher les mêmes risques, filtrés et triés différemment, ils pointent tous vers la même base de données et affichent chacun une vue différente. Modifiez la ligne source une seule fois, et toutes les vues qui la contiennent sont mises à jour.
Pour le second problème, une base de données gère avec aisance des usages pour lesquels Jira n'a jamais été conçu. Registres de fournisseurs. Veille concurrentielle. Pipelines de recrutement. Journaux de preuves de conformité. Suivi d'événements. Calendriers éditoriaux. Recueils de procédures opérationnelles, où chaque ligne est une procédure liée à son runbook. Jira excelle pour les tickets, mais une grande partie des données opérationnelles ne sont pas des tickets, et une grande partie finit par défaut dans des feuilles de calcul, simplement parce que personne ne voulait créer un nouvel outil.
Les fonctionnalités que les équipes ignorent avoir
Un tour d'horizon pratique, à peu près classé selon la fréquence à laquelle elles s'avèrent rentables.
Plusieurs vues sur les mêmes données. Une même base de données peut s'afficher sous forme de tableau, de board (de type Kanban), de grille de cartes ou de galerie. Chaque vue possède ses propres filtres, tris et champs visibles. La vue tableau pour la gestion de projet, la vue board pour les mêmes lignes regroupées par statut, la vue cartes pour les mêmes lignes filtrées sur « en revue » : toutes pointent vers un seul jeu de données. C'est la fonctionnalité qui change discrètement la façon dont le contenu structuré vit dans Confluence. Au lieu d'un rapport et d'un dossier de captures d'écran copiées-collées, vous disposez d'une seule source et de multiples points d'accès.
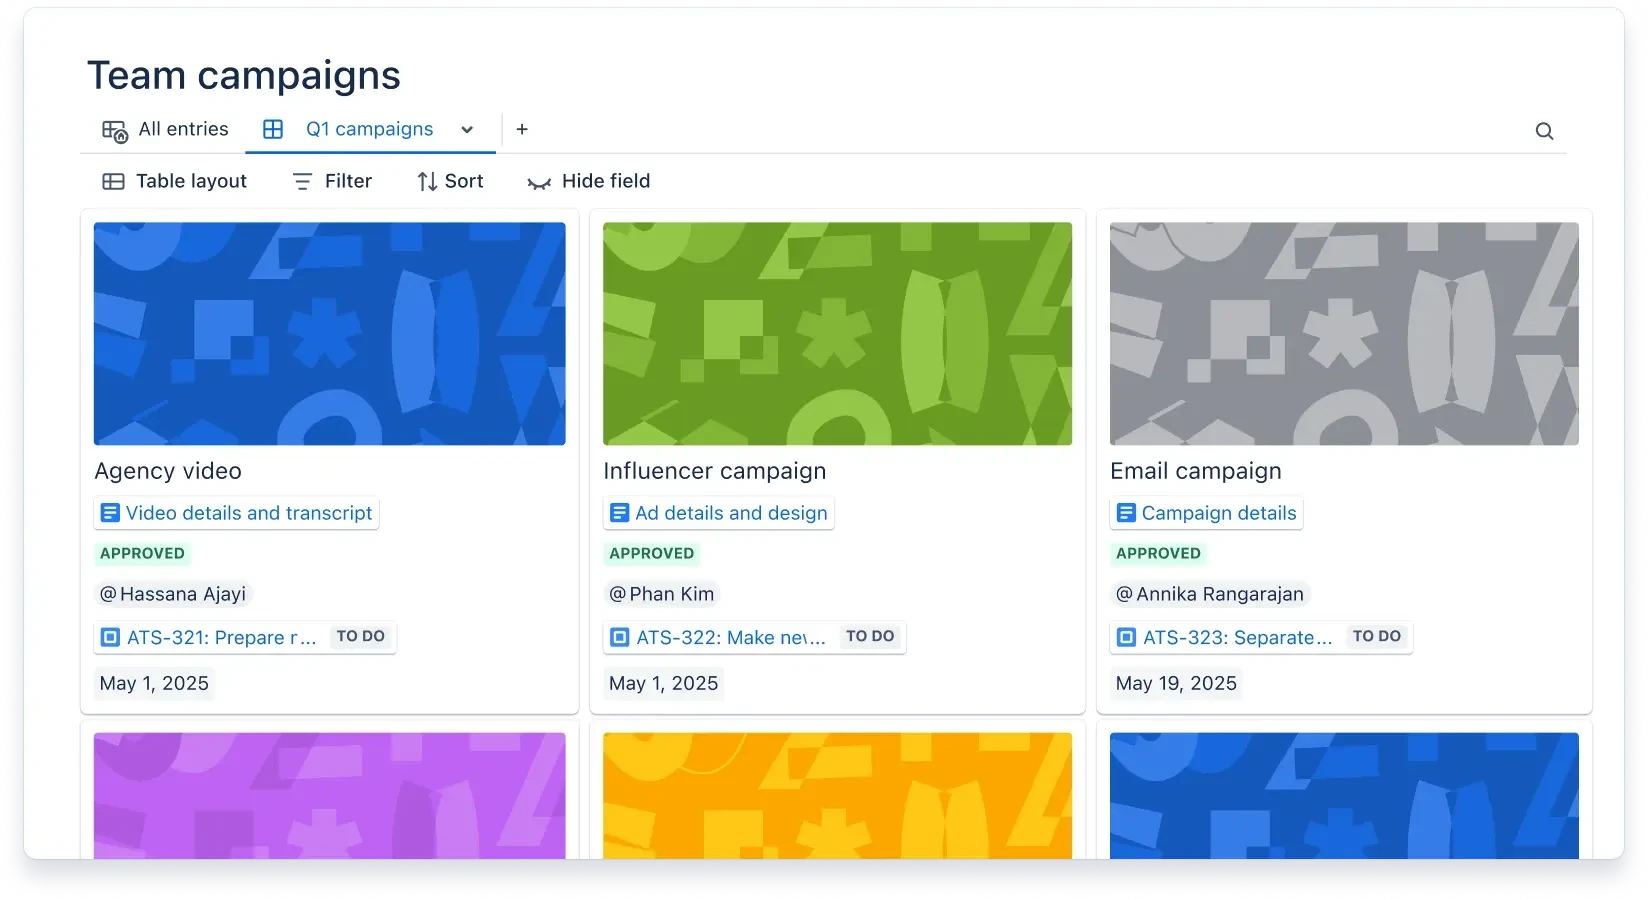
Des Smart Links dans les champs. Un champ de lien dans une base de données ne s'affiche pas comme une URL bleue. Il s'affiche comme un Smart Link : un ticket Jira apparaît sous forme de pastille typée avec son statut, un fichier Figma sous forme de miniature, une vidéo Loom avec un bouton de lecture et un Google Doc sous forme de carte d'aperçu. Les bases de données deviennent ainsi un hub pour le contenu de plusieurs outils, ce qu'un simple tableau ne pourra jamais être. Une ligne de projet peut contenir son epic Jira, son fichier de design, sa page de spécifications, son tableau de rétrospective et l'enregistrement de sa démo dans cinq champs bien distincts.
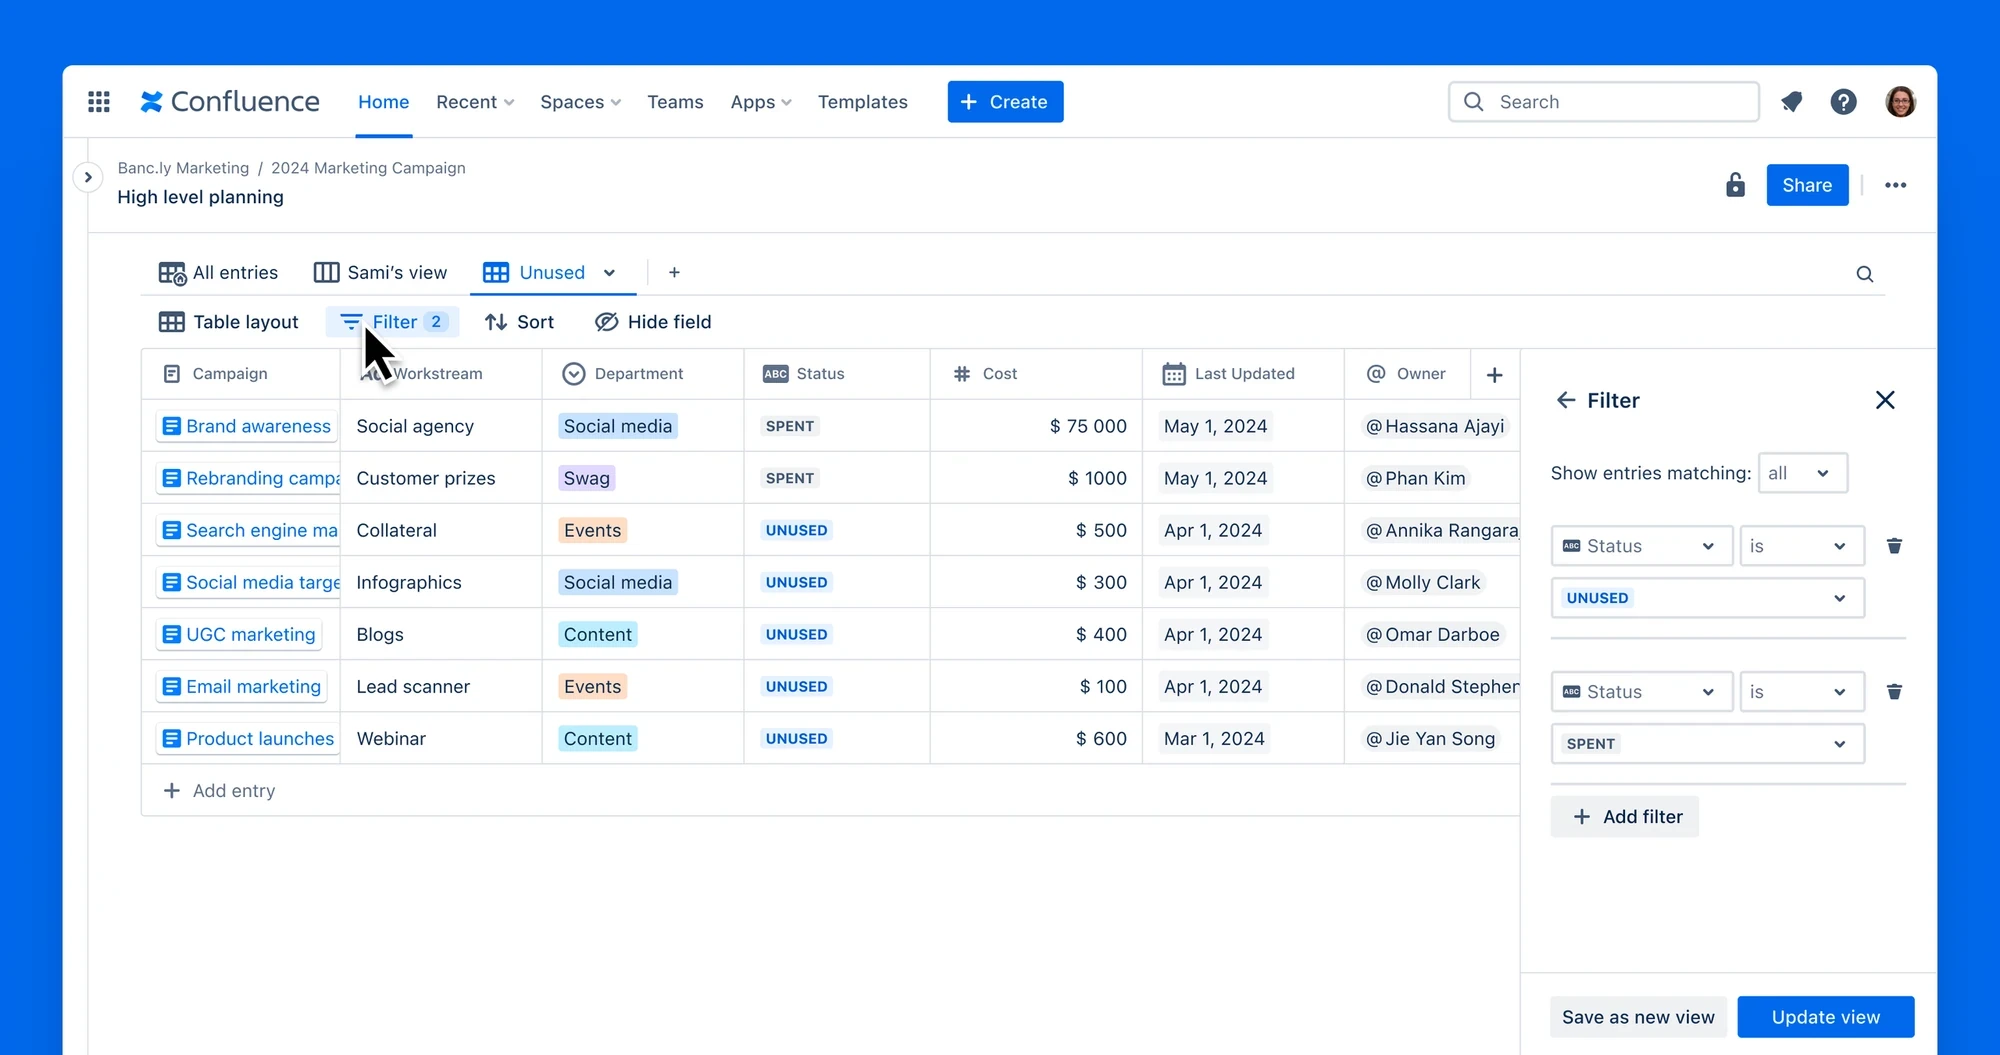
Un filtrage logique, pas seulement par mots-clés. N'importe quel champ peut servir à filtrer une vue, y compris avec des filtres composés utilisant la logique ET/OU, et vous pouvez enregistrer ces filtres sous forme de vues nommées. « Risques dont je suis responsable, ouverts au cours des trente derniers jours, statut différent de Terminé » est une vue. « Fonctionnalités prévues pour la prochaine version, toutes équipes confondues » en est une autre. Vous créez une vue une seule fois, vous partagez son lien, et les nouveaux arrivants voient immédiatement la même sélection que vous.
Intégrer une vue n'importe où. Une vue de base de données possède sa propre URL, et cette URL se comporte comme un Smart Link. Vous pouvez la coller dans une page Confluence, dans une autre base de données, dans la description d'un ticket Jira ou dans un message Slack. L'intégration est dynamique. Les lecteurs de la page voient les données actuelles, et non une capture d'écran périmée à l'instant même où elle a été prise.
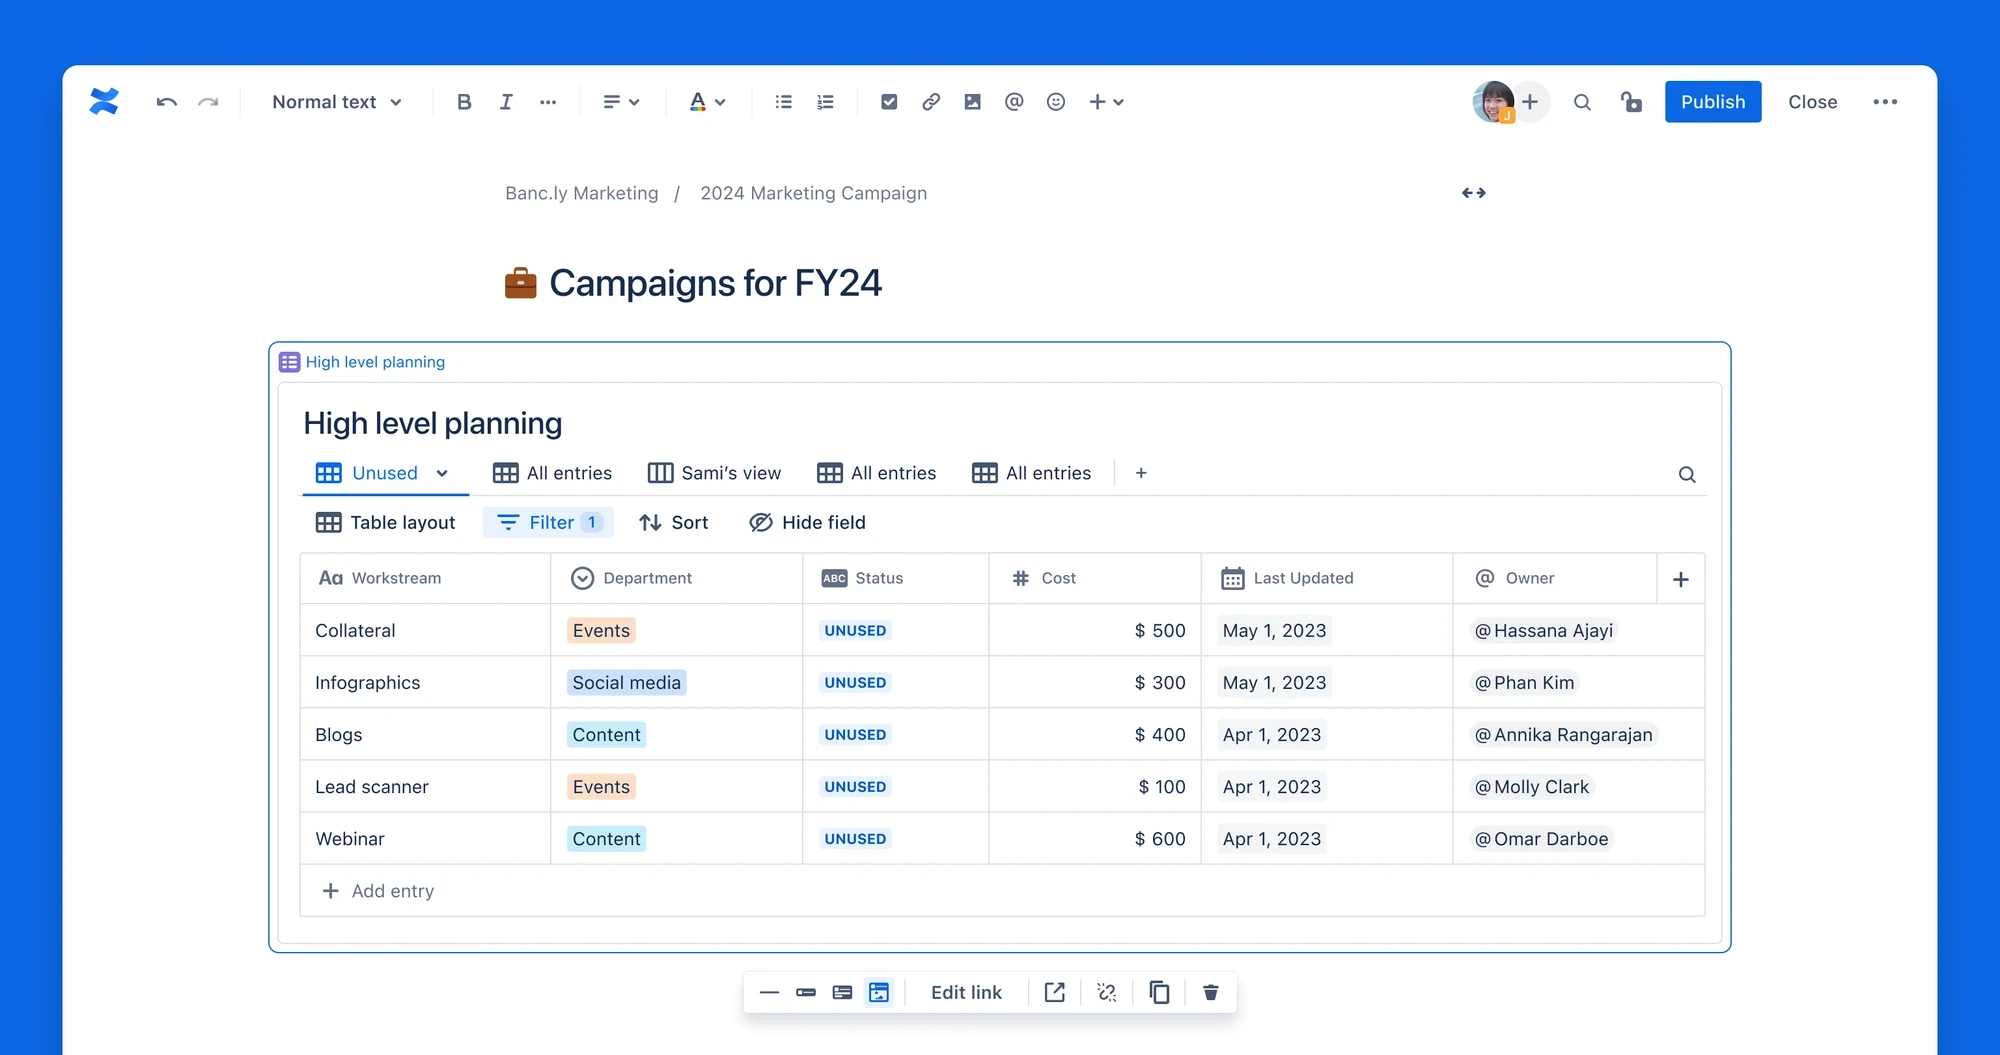
Modification en ligne depuis n'importe où. Vous pouvez modifier une ligne directement depuis l'intégration, sans quitter la page. Pour la plupart des équipes, le plus grand changement de comportement est que la page de « données structurées » cesse d'être un dashboard en lecture seule pour devenir un véritable espace de travail. Le statut est mis à jour sur la page même où il est présenté.
Ce que les bases de données ne sont pas (encore)
Ce ne sont pas des feuilles de calcul. Il n'y a pas de formules de cellule, pas de SOMME.SI, pas de tableaux croisés dynamiques. Si votre workflow consiste à « calculer un score pondéré sur quinze lignes et en faire un graphique », vous atteindrez vite les limites.
Elles ne gèrent pas les autorisations au niveau des lignes. Les bases de données héritent des autorisations de l'espace. Une base de données dans un espace public est une base de données publique. Par défaut, vous ne pouvez pas montrer un ensemble de lignes au Marketing et un autre à la Finance. C'est une vraie lacune pour les environnements réglementés, et c'est la principale raison pour laquelle certaines équipes conservent encore des feuilles de calcul pour les données sensibles.
Elles ne sont pas encore entièrement indexées par Rovo. En avril 2026, la recherche Rovo peut faire remonter les bases de données en tant qu'objets, mais le contenu des entrées n'est pas toujours renvoyé lorsque vous posez une question à Rovo sur l'ensemble de votre espace de travail. Atlassian progresse régulièrement sur ce point et l'écart se réduit, mais mieux vaut le savoir si votre équipe utilise Rovo comme moteur de recherche universel. Une petite astuce : tenez à jour, pour chaque base de données, une page de synthèse rédigée en texte simple, afin que Rovo ait quelque chose à renvoyer lorsque quelqu'un pose une question sur son contenu.
Elles n'expirent pas, ne s'archivent pas et ne s'approuvent pas d'elles-mêmes. Une entrée de base de données existe indéfiniment, à moins que quelqu'un ne la supprime. Cela ne pose aucun problème jusqu'au jour où votre registre de fournisseurs compte quatre cents entrées, dont la moitié correspond à des organisations qui ont cessé d'exister en 2023. Les bases de données vous offrent un stockage structuré. Elles ne vous offrent pas de gouvernance. Associez-les à des règles d'automatisation lorsque c'est possible, et à des approbations formelles lorsque c'est indispensable.
Cinq modèles à reprendre sans hésiter
Des usages concrets des bases de données par des équipes très performantes, qui méritent d'être repris dès aujourd'hui.
Le journal des décisions. Une ligne par décision, avec des champs pour la décision, la date, le responsable, le contexte, la page de proposition liée et le compte rendu de réunion lié. Une vue filtrée par équipe sert à l'onboarding. Une vue filtrée sur « les quatre-vingt-dix derniers jours » alimente la revue mensuelle. En deux ans, la base de données devient l'actif le plus précieux de l'équipe, et cela mérite d'être dit clairement : dans la plupart des entreprises, la plupart des décisions sont perdues en moins d'un an, et le journal des décisions est l'artefact au plus fort effet de levier que la plupart des équipes ne créent jamais.
Le suivi des concurrents. Une ligne par concurrent, avec des champs pour le segment, le positionnement, le niveau de prix, les lancements récents (sélection multiple), les analyses détaillées liées et les informations commerciales liées. Les équipes produit et marketing partagent la même vue. L'équipe de sales enablement dispose d'une vue filtrée. Les mises à jour se font à un seul endroit. Votre veille concurrentielle cesse d'être répartie dans cinq feuilles de calcul gérées par cinq personnes différentes.
Le journal des preuves de conformité. Une ligne par contrôle, avec des champs pour le référentiel (SOC 2, ISO 27001, FDA), la date de dernière revue, le responsable, le document de preuve lié et la date de la prochaine revue. Un board regroupé par référentiel. Une vue filtrée sur les « contrôles revus au cours des quatre-vingt-dix derniers jours » structure la réunion avec l'auditeur.
Ce dernier point mérite qu'on s'y arrête. Les bases de données excellent dans le suivi d'informations structurées. Elles ne sont pas conçues pour la couche de gouvernance qui vient par-dessus. Chez Capable, nous le constatons régulièrement : des équipes créent un superbe journal de preuves dans une base de données, puis se rendent compte qu'elles ont besoin d'approbations dignes d'un audit, d'expirations et de seuils de validation sur les entrées. C'est là qu'intervient Capable Approval, aux côtés de la base de données plutôt qu'en concurrence avec elle. Les bases de données stockent les données. Capable Approval encadre la validation. Ensemble, elles vous offrent quelque chose qu'un auditeur acceptera réellement.
Des optimisations de workflow à mettre en place dès cette semaine
Trois actions concrètes, par ordre d'effort croissant.
Un. Choisissez un tableau que tout le monde copie-colle. Chaque équipe en a un. Remplacez-le par une base de données. Choisissez trois champs qui devraient être typés, ajoutez-les et reconstruisez le tableau sous forme de vue de base de données. Le bénéfice est immédiat : la prochaine personne qui devra mettre à jour les données le fera à un seul endroit.
Deux. Ajoutez une deuxième vue à cette base de données. Si la première vue est un tableau, faites de la deuxième un board. Si la première est un board, faites de la deuxième un tableau filtré sur la semaine en cours. Vous serez surpris de la rapidité avec laquelle on vous demandera une troisième vue.
Trois. Référencez une base de données depuis une page. Intégrez-en une vue spécifique sur la page de présentation du projet, filtrée sur les lignes pertinentes pour cette page. Cette seule action transforme une page de présentation statique en page de statut dynamique, et fait passer la base de données du statut de « truc quelque part » à celui d'« outil dans lequel vous travaillez tous les jours ». Dès lors, chacun y ajoute naturellement des données, car c'est là que les données doivent réellement se trouver.
Là où les bases de données rencontrent Capable
Soyons honnêtes. Les bases de données sont efficaces pour le stockage structuré, les champs typés, les vues filtrées et l'intégration de données dynamiques là où elles sont lues. Elles ne constituent ni une couche de gouvernance, ni une couche de publication, ni un gestionnaire de ressources visuelles, et elles ne permettent pas de modéliser tout ce qui se présente dans le travail opérationnel réel.
Là où s'arrêtent les bases de données et où Capable prend le relais.
Approbations et audit. Capable Approval prend en charge la couche de validation, d'expiration et de piste d'audit que les bases de données ne couvrent pas. Une ligne de base de données marquée « approuvée » n'est qu'un champ de texte libre. Un événement d'approbation dans Capable est un enregistrement signé, journalisé et inviolable, avec des seuils de validation et des règles d'expiration. Les équipes soumises à SOC 2, à l'ISO ou à des référentiels réglementaires ont besoin du second.
Gestion des ressources visuelles. Les bases de données peuvent référencer des images via un Smart Link, mais ce ne sont pas des bibliothèques d'images. Si votre équipe gère des centaines de captures d'écran, de logos et de schémas qui doivent être réutilisés sur plusieurs pages, versionnés, annotés et remplacés à un seul endroit, Capable Image Library est l'outil qu'il vous faut. Elle fonctionne naturellement aux côtés des bases de données, sans chercher à les remplacer.
Calendriers de versions et de publication. Les bases de données proposent des vues calendrier. Elles ne coordonnent pas le cycle de livraison lui-même, l'embargo, le gel du contenu, la file de publication. C'est là qu'intervient Capable Calendar : il offre aux équipes un calendrier partagé qui traite les versions, les publications et les événements comme des objets à part entière, avec leurs propres autorisations et notifications.
Des diagrammes au-delà des logigrammes. Référencer un fichier de diagramme dans une ligne de base de données ne pose aucun problème. Concevoir de véritables diagrammes d'architecture, des modèles C4, du BPMN ou de l'UML ne relève pas d'une base de données. Pour cela, Capable Diagrams vient compléter la base de données.
Publier en dehors de Confluence. Une vue de base de données reste un objet Confluence. Si les données doivent atteindre un portail client, un site partenaire ou une base de connaissances publique, Capable Publisher (et Capable Sites) prennent en charge cette surface externe.
Pour le dire en quelques mots : les bases de données Confluence représentent une véritable avancée pour le stockage et l'interrogation des données sur la plateforme. Capable constitue la couche opérationnelle qui les entoure : la gouvernance, les ressources visuelles, la planification, la publication externe, les outils spécialisés que les bases de données n'ont jamais prétendu être.
Une perspective plus large
L'essentiel de ce qui distingue une équipe qui maîtrise Confluence d'une équipe qui se contente de l'utiliser ne tient pas au nombre de fonctionnalités qu'elle connaît. Cela tient aux briques de base qu'elle choisit. Une équipe qui utilise des pages avec des tableaux pour tout travaille contre la plateforme. Une équipe qui choisit entre pages, bases de données, blocs synchronisés, tableaux blancs et Smart Links selon la forme de ce qu'elle modélise travaille avec elle.
Les bases de données valent la peine d'être maîtrisées, car elles ouvrent la voie à un Confluence d'un tout autre genre. Un Confluence où les données structurées sont des objets à part entière, où les vues ne coûtent presque rien et où la version de référence de chaque jeu de données se trouve à un seul et unique endroit. Le bénéfice ne se manifeste pas dans une fonctionnalité en particulier, mais dans la disparition progressive de toutes ces petites façons dont les connaissances de votre équipe finissaient par diverger.
Si vous comptiez essayer sérieusement les bases de données sans jamais trouver le temps, c'est le moment. Choisissez le tableau le plus copié de votre espace de travail. Déplacez-le. Et observez ce qui se passe.
👉 Consultez la documentation complète sur les bases de données Confluence