English
 Deutsch
 Français
 Español
Confluence-Datenbanken: Leitfaden für Power-User 2026
Confluence-Datenbanken haben sich unbemerkt zu einem der leistungsfähigsten Grundbausteine der Plattform entwickelt. Trotzdem bilden die meisten Teams strukturierte Daten weiterhin in einfachen Tabellen, angehängten Tabellenkalkulationen oder Jira-Vorgängen ab, die dafür nie gedacht waren. Ein Praxisleitfaden zu Datenbanken, wie Power-User sie tatsächlich nutzen: mit dem Funktionsumfang von 2026, den Stolperfallen und den Stellen, an denen Capable die Lücken schließt.

Bitten Sie ein Team, das Confluence nutzt, Ihnen seine „wichtigen strukturierten Daten“ zu zeigen, und Sie bekommen fast immer dieselben drei Dinge zu sehen. Eine lange, starre Tabelle auf einer Wiki-Seite mit verbundenen Zellen, die schon vor drei Quartalen kaputtgegangen sind. Ein Google Sheet, oben auf der Seite angeheftet, mit einem Tab namens „aktuell“, der seit Februar nicht mehr aktuell ist. Oder ein Jira-Epic mit 87 verknüpften Vorgängen, ohne Filter, und einer Ansicht, die seit Monaten niemand geöffnet hat.
Nichts davon ist 2026 der richtige Ort für strukturierte Daten in Confluence. Confluence-Datenbanken sind es.
Wenn Sie sich Datenbanken seit ihrer Einführung nicht mehr ernsthaft angesehen haben, lohnt sich ein zweiter Blick. Atlassian hat in den letzten achtzehn Monaten beharrlich daran weiterentwickelt, und der Funktionsumfang hat unbemerkt die Schwelle vom „interessanten Prototyp“ zum „zentralen Grundbaustein des Arbeitsbereichs“ überschritten. Dieser Beitrag ist ein Praxisleitfaden von einem Team, das täglich damit arbeitet.
Was eine Datenbank eigentlich ist, in einem Absatz
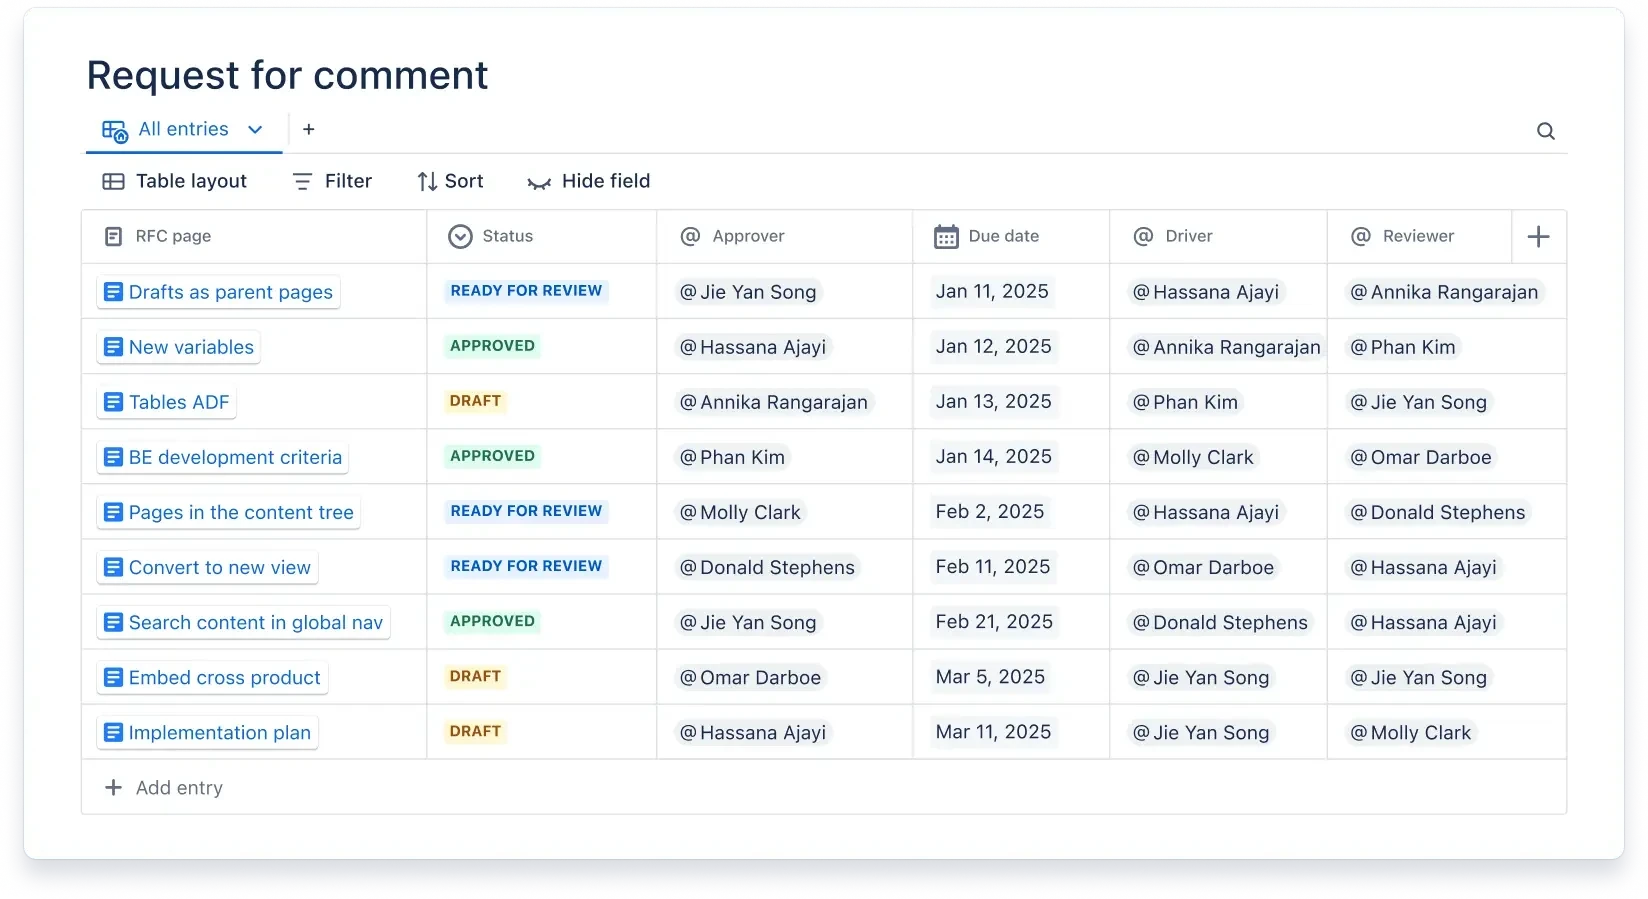
Eine Confluence-Datenbank ist ein typisierter, abfragbarer Datenspeicher, der neben Ihren Seiten existiert. Sie ist kein Makro. Sie ist keine angehängte Datei. Sie ist ein vollwertiges Objekt in Ihrem Inhaltsbaum, mit eigener URL, eigenen Berechtigungen und eigenen Ansichten. Sie füllen Zeilen („Einträge“), die Felder sind typisiert (Text, Zahl, Datum, Auswahl, Mehrfachauswahl, Link, Benutzer, Jira-Vorgang und eine wachsende Liste weiterer Typen), und jede Ansicht der Daten lässt sich überall einbetten, wo ein Smart Link eingebettet werden kann – also fast überall.
Am ehesten vergleichbar ist das mit einer Notion-Datenbank oder einer Airtable-Base, nur dass sie in Confluence integriert und nicht nachträglich angeflanscht ist. Diese Ähnlichkeit ist gewollt und inzwischen so ausgeprägt, dass sie echten Nutzen bringt.
Wo Datenbanken den Alternativen überlegen sind
Teams meiden Datenbanken aus zwei Gründen. Erstens wirkt „Wir haben doch schon eine Tabelle“ wie ein gelöstes Problem, bis Sie dieselben Daten an drei Stellen bearbeiten müssen. Zweitens scheint „Wir haben doch schon Jira“ strukturierte Arbeit abzudecken, bis Sie versuchen, etwas abzubilden, das kein Ticket, kein Sprint und kein Epic ist.
Datenbanken entkräften beide Einwände, und zwar gründlich.
Beim ersten Problem ersetzt eine Datenbank eine seitengebundene Tabelle durch einen gemeinsamen Datensatz. Der Datensatz ist die maßgebliche Version. Ansichten darauf sind Projektionen. Wenn Ihre Projektstatusseite, Ihr Betriebs-Dashboard und Ihre wöchentliche E-Mail dieselben Risiken unterschiedlich gefiltert und sortiert zeigen sollen, verweisen alle auf dieselbe Datenbank und stellen jeweils eine andere Ansicht dar. Ändern Sie die zugrunde liegende Zeile einmal, und jede Ansicht, die sie enthält, wird aktualisiert.
Beim zweiten Problem bewältigt eine Datenbank mühelos Dinge, für die Jira nie gedacht war. Lieferantenverzeichnisse. Wettbewerbsanalysen. Recruiting-Pipelines. Protokolle für Compliance-Nachweise. Veranstaltungsplanung. Redaktionspläne. Rezeptsammlungen für SOPs, in denen jede Zeile ein Verfahren mit verknüpftem Runbook ist. Jira ist hervorragend für Vorgänge, aber viele operative Daten sind keine Vorgänge, und vieles davon landet standardmäßig in Tabellenkalkulationen, einfach weil niemand ein neues Tool bauen wollte.
Funktionen, von denen Teams nichts wissen
Ein Rundgang aus der Praxis, grob sortiert danach, wie oft sich die Funktionen auszahlen.
Mehrere Ansichten auf dieselben Daten. Eine einzelne Datenbank lässt sich als Tabelle, Board (im Kanban-Stil), Kartenraster oder Galerie darstellen. Jede Ansicht hat eigene Filter, Sortierungen und sichtbare Felder. Die Tabellenansicht für das Projektmanagement, die Board-Ansicht mit denselben Zeilen nach Status gruppiert, die Kartenansicht mit denselben Zeilen gefiltert auf „In Prüfung“ – alle greifen auf einen Datensatz zu. Diese Funktion verändert unbemerkt, wie strukturierte Inhalte in Confluence leben. Statt eines Berichts und eines Ordners voller kopierter Screenshots haben Sie eine Quelle und viele Darstellungen.
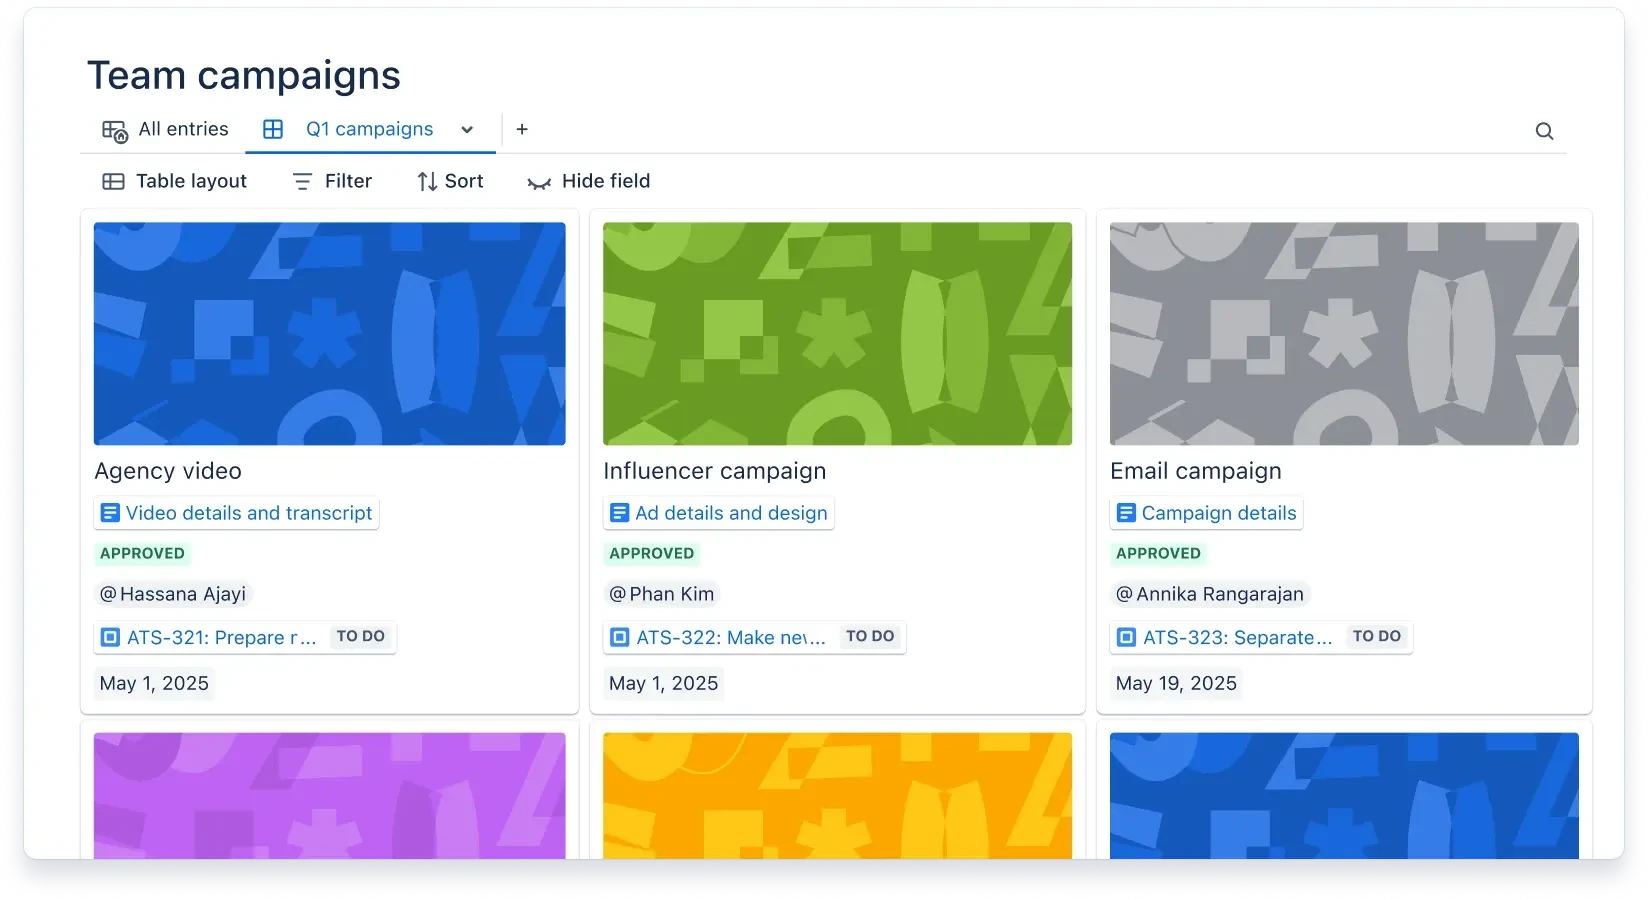
Smart Links in Feldern. Ein Link-Feld in einer Datenbank wird nicht als blaue URL dargestellt, sondern als Smart Link. Ein Jira-Vorgang erscheint also als typisiertes Label mit Status, eine Figma-Datei als Vorschaubild, ein Loom-Video mit Wiedergabe-Schaltfläche und ein Google-Dokument als Vorschaukarte. Datenbanken werden so zur zentralen Anlaufstelle für toolübergreifende Inhalte, wie es eine einfache Tabelle nie sein kann. Eine Projektzeile kann ihr Jira-Epic, ihre Designdatei, ihre Spezifikationsseite, ihr Retro-Board und ihre Demo-Aufzeichnung in fünf übersichtlichen Feldern enthalten.
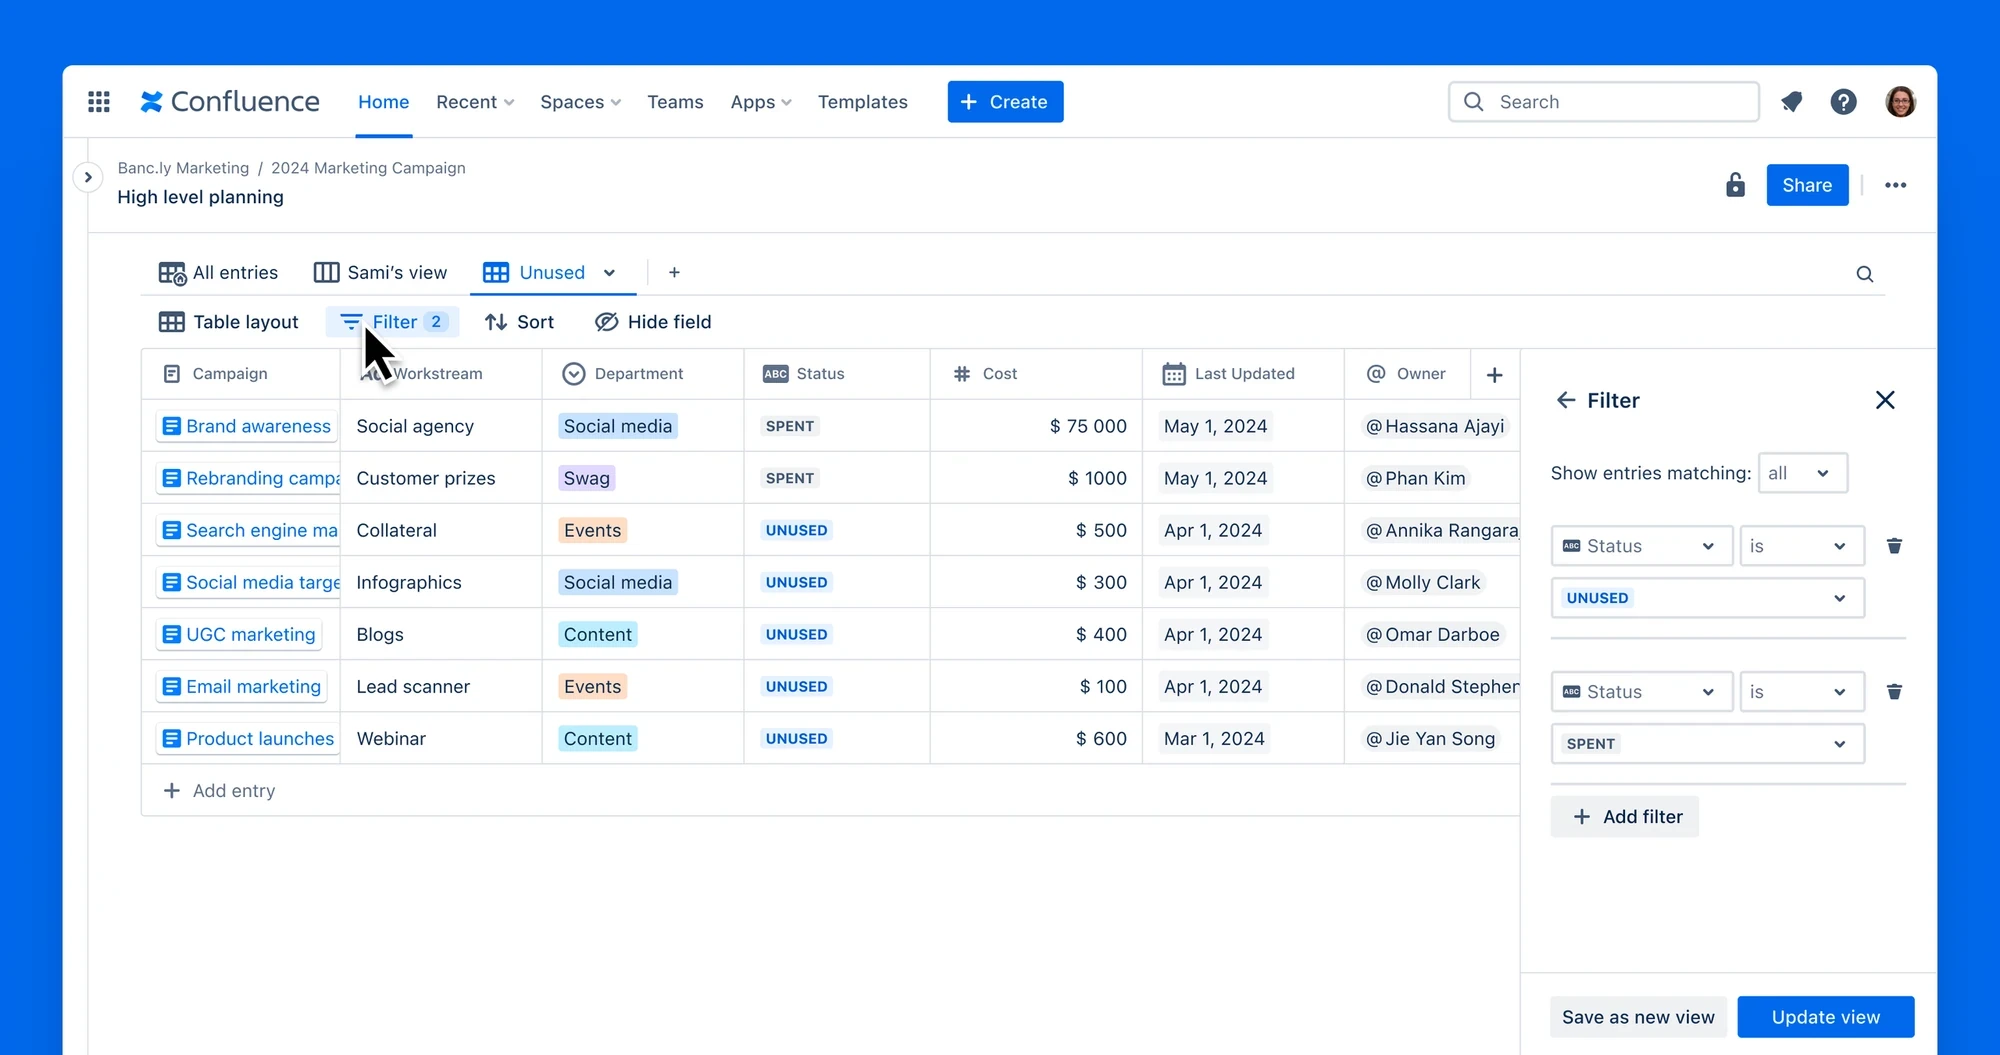
Filtern mit Logik statt nur mit Stichwörtern. Jedes Feld kann zum Filtern einer Ansicht dienen, auch mit zusammengesetzten Filtern mit UND/ODER-Logik, und Sie können diese Filter als benannte Ansichten speichern. „Risiken, für die ich verantwortlich bin, in den letzten 30 Tagen eröffnet, Status nicht Erledigt“ ist eine Ansicht. „Funktionen für das nächste Release, über alle Teams hinweg“ ist eine andere. Sie erstellen eine Ansicht einmal, teilen den Link, und neue Teammitglieder sehen sofort denselben Ausschnitt wie Sie.
Ansichten überall einbetten. Jede Datenbankansicht hat eine eigene URL, und diese URL funktioniert als Smart Link. Sie können sie in eine Confluence-Seite, in eine andere Datenbank, in die Beschreibung eines Jira-Tickets oder in eine Slack-Nachricht einfügen. Die Einbettung ist live. Wer die Seite liest, sieht die aktuellen Daten und keinen Screenshot, der schon beim Erstellen veraltet war.
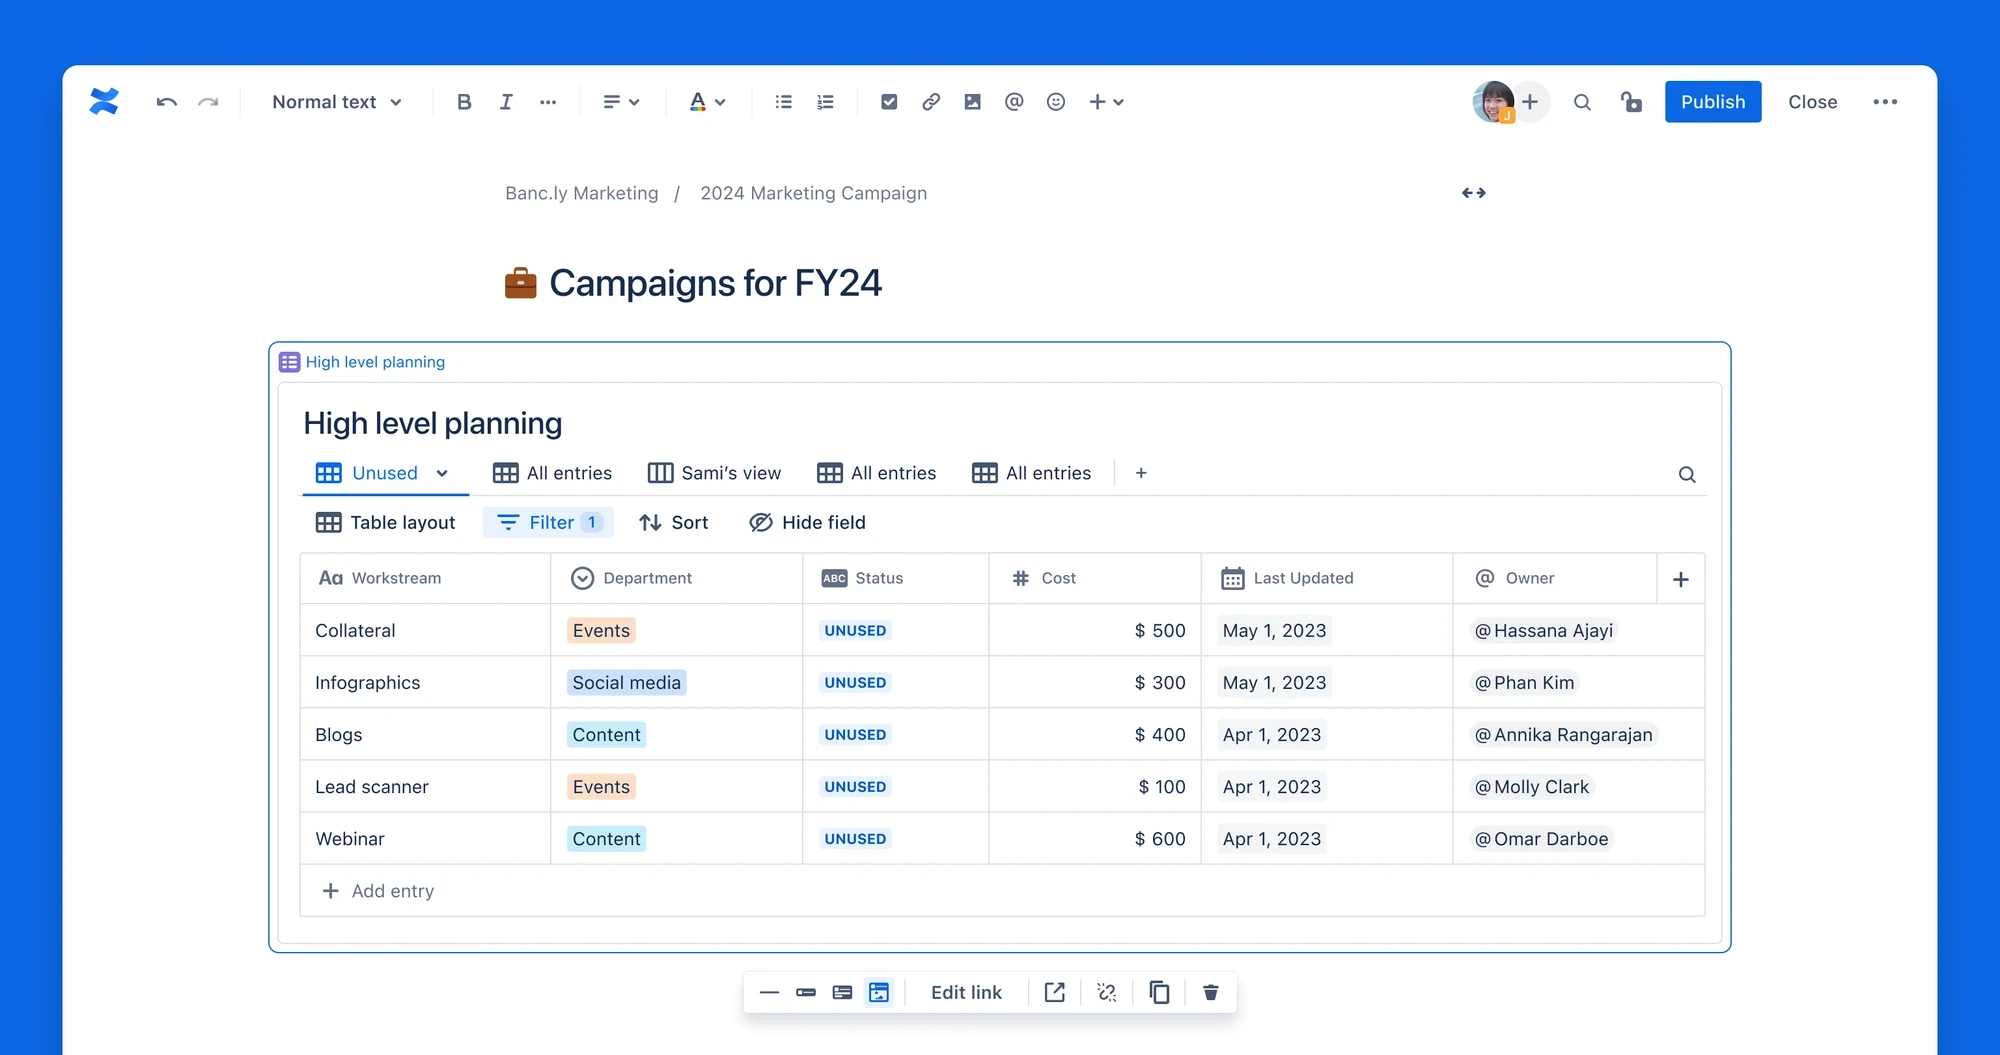
Direkt bearbeiten, egal wo. Sie können eine Zeile direkt in der Einbettung bearbeiten, ohne die Seite zu verlassen. Für die meisten Teams ist das die größte Veränderung im Arbeitsalltag: Die Seite mit den „strukturierten Daten“ ist kein schreibgeschütztes Dashboard mehr, sondern wird zur Arbeitsfläche. Der Status wird auf derselben Seite aktualisiert, auf der er berichtet wird.
Was Datenbanken (noch) nicht sind
Sie sind keine Tabellenkalkulation. Es gibt keine Zellformeln, kein SUMMEWENN und keine Pivot-Tabellen. Wenn Ihr Workflow lautet „gewichteten Score über fünfzehn Zeilen berechnen und als Diagramm darstellen“, stoßen Sie schnell an Grenzen.
Sie haben keine Berechtigungen auf Zeilenebene. Datenbanken übernehmen die Berechtigungen des Bereichs. Eine Datenbank in einem öffentlichen Bereich ist eine öffentliche Datenbank. Standardmäßig können Sie dem Marketing nicht andere Zeilen zeigen als der Finanzabteilung. Für regulierte Umgebungen ist das eine echte Lücke – und der Hauptgrund, warum manche Teams für sensible Daten weiterhin Tabellenkalkulationen nutzen.
Sie werden von Rovo noch nicht vollständig indexiert. Stand April 2026 findet die Rovo-Suche Datenbanken zwar als Objekte, doch die Inhalte der Datenbankeinträge werden nicht immer ausgegeben, wenn Sie Rovo eine Frage zu Ihrem gesamten Workspace stellen. Atlassian arbeitet kontinuierlich daran, und die Lücke wird kleiner. Wenn Ihr Team Rovo als zentrale Suche nutzt, sollten Sie das trotzdem wissen. Ein einfacher Workaround: Legen Sie zu jeder Datenbank eine Übersichtsseite in Fließtext an. So hat Rovo etwas, das es ausgeben kann, wenn jemand nach den Inhalten fragt.
Sie laufen nicht ab, archivieren sich nicht und genehmigen sich nicht selbst. Ein Datenbankeintrag bleibt für immer bestehen, sofern ihn niemand löscht. Das klingt harmlos – bis Ihr Lieferantenverzeichnis vierhundert Einträge hat und die Hälfte davon Organisationen sind, die es seit 2023 nicht mehr gibt. Datenbanken bieten strukturierte Speicherung, aber keine Governance. Kombinieren Sie sie, wo möglich, mit Automatisierungsregeln und, wo nötig, mit formalen Genehmigungen.
Fünf Muster, die Sie übernehmen sollten
Konkrete Arten, wie leistungsstarke Teams Datenbanken nutzen – und die Sie schon heute übernehmen können.
Das Entscheidungsprotokoll. Eine Zeile pro Entscheidung, mit Feldern für Entscheidung, Datum, Verantwortliche, Kontext, verknüpfte Vorschlagsseite und verknüpfte Besprechungsnotizen. Eine nach Team gefilterte Ansicht dient dem Onboarding. Eine auf die „letzten neunzig Tage“ gefilterte Ansicht dient dem Monatsreview. Nach zwei Jahren ist die Datenbank das wertvollste einzelne Asset des Teams. Das sollte man klar sagen: Die meisten Entscheidungen in den meisten Unternehmen gehen innerhalb eines Jahres verloren, und ein Entscheidungsprotokoll ist das wirkungsvollste Artefakt, das die meisten Teams nie anlegen.
Der Wettbewerbs-Tracker. Eine Zeile pro Wettbewerber, mit Feldern für Segment, Positionierung, Preisstufe, aktuelle Produkteinführungen (Mehrfachauswahl), verknüpfte Analysedokumente und verknüpfte Vertriebsinformationen. Produkt und Marketing sehen dieselbe Ansicht. Sales Enablement erhält eine gefilterte Ansicht. Aktualisiert wird an einer Stelle. Ihre Wettbewerbsanalyse besteht nicht mehr aus fünf Tabellen von fünf verschiedenen Personen.
Das Nachweisprotokoll für Compliance. Eine Zeile pro Kontrolle, mit Feldern für Rahmenwerk (SOC 2, ISO 27001, FDA), letzte Prüfung, Verantwortliche, verknüpftes Nachweisdokument und nächster Prüftermin. Ein Board, gruppiert nach Rahmenwerk. Eine gefilterte Ansicht der „in den letzten neunzig Tagen geprüften Kontrollen“ bildet die Grundlage für das Gespräch mit dem Auditor.
Dieser letzte Punkt verdient besondere Beachtung. Datenbanken eignen sich hervorragend, um strukturierte Informationen zu erfassen. Für die Governance-Ebene darüber sind sie nicht gebaut. Bei Capable sehen wir das regelmäßig: Teams bauen ein hervorragendes Nachweisprotokoll in einer Datenbank auf und merken dann, dass sie für die Einträge auditfeste Genehmigungen, Ablaufdaten und Schwellenwerte für Prüfer brauchen. Genau hier kommt Capable Approval ins Spiel – als Ergänzung zur Datenbank, nicht als Konkurrenz. Datenbanken speichern die Daten. Capable Approval steuert die Freigabe. Zusammen erhalten Sie etwas, das ein Auditor tatsächlich akzeptiert.
Workflow-Optimierungen für diese Woche
Drei konkrete Schritte, nach steigendem Aufwand geordnet.
Erstens. Wählen Sie eine Tabelle, die alle per Copy-and-paste weitergeben. Jedes Team hat eine. Ersetzen Sie sie durch eine Datenbank. Wählen Sie drei Felder, die typisiert sein sollten, legen Sie sie an und bauen Sie die Tabelle als Datenbankansicht neu auf. Der unmittelbare Nutzen: Wer die Daten als Nächstes aktualisieren muss, tut das an einer einzigen Stelle.
Zweitens. Fügen Sie dieser Datenbank eine zweite Ansicht hinzu. Ist die erste Ansicht eine Tabelle, machen Sie die zweite zu einem Board. Ist die erste ein Board, machen Sie die zweite zu einer gefilterten Tabelle für die aktuelle Woche. Sie werden staunen, wie schnell jemand nach Ansicht Nummer drei fragt.
Drittens. Binden Sie eine Datenbank in eine Seite ein. Betten Sie eine bestimmte Ansicht auf der Projektübersichtsseite ein, gefiltert auf die Zeilen, die für diese Seite relevant sind. Dieser eine Schritt macht aus einer statischen Übersichtsseite eine Live-Statusseite – und aus der Datenbank wird statt „irgendetwas da drüben“ „das, womit Sie jeden Tag arbeiten“. Sobald das passiert, pflegen die Leute ihre Daten ganz selbstverständlich dort ein, weil die Daten genau dort hingehören.
Wo Datenbanken auf Capable treffen
Ganz ehrlich: Datenbanken sind gut in strukturierter Speicherung, typisierten Feldern, gefilterten Ansichten und darin, Live-Daten dort einzubetten, wo sie gelesen werden. Sie sind keine Governance-Ebene, keine Publishing-Ebene und keine Verwaltung für visuelle Assets, und sie bilden nicht alles ab, was in der tatsächlichen operativen Arbeit anfällt.
Wo Datenbanken aufhören und Capable übernimmt.
Genehmigungen und Audit. Capable Approval übernimmt Freigabe, Ablaufdaten und Audit-Trail – also genau das, was Datenbanken nicht leisten. Eine Datenbankzeile mit dem Vermerk „genehmigt“ ist ein Freitextfeld. Ein Genehmigungsereignis in Capable ist ein signierter, protokollierter, manipulationssicherer Datensatz mit Schwellenwerten für Prüfer und Ablaufregeln. Teams, die SOC 2, ISO oder anderen regulatorischen Rahmenwerken unterliegen, brauchen Letzteres.
Verwaltung visueller Assets. Datenbanken können Bilder per Smart Link referenzieren, sind aber keine Bildbibliothek. Wenn Ihr Team Hunderte von Screenshots, Logos und Diagrammen pflegt, die auf mehreren Seiten wiederverwendet, versioniert, kommentiert und zentral ausgetauscht werden müssen, ist Capable Image Library das richtige Tool. Es ergänzt Datenbanken ganz selbstverständlich, statt sie ersetzen zu wollen.
Release- und Veröffentlichungskalender. Datenbanken bieten Kalenderansichten. Den eigentlichen Release-Zyklus, Sperrfristen, Content Freeze und die Veröffentlichungswarteschlange koordinieren sie nicht. Hier kommt Capable Calendar ins Spiel: Es bietet Teams einen gemeinsamen Kalender, der Releases, Veröffentlichungen und Termine als vollwertige Objekte mit eigenen Berechtigungen und Benachrichtigungen behandelt.
Diagramme, die keine Flussdiagramme sind. Ein Verweis auf eine Diagrammdatei in einer Datenbankzeile ist in Ordnung. Anspruchsvolle Architekturdiagramme, C4-Modelle, BPMN oder UML zu erstellen, ist jedoch keine Aufgabe für eine Datenbank. Dafür gibt es Capable Diagrams als Ergänzung zur Datenbank.
Veröffentlichen außerhalb von Confluence. Eine Datenbankansicht bleibt ein Confluence-Objekt. Wenn die Daten ein Kundenportal, eine Partner-Website oder eine öffentliche Wissensdatenbank erreichen sollen, übernehmen Capable Publisher (und Capable Sites) die externe Darstellung.
Kurz gesagt: Confluence Databases sind ein echter Fortschritt für Speicherung und Abfragen auf der Plattform. Capable ist die operative Ebene drumherum – Governance, visuelle Assets, Terminplanung, externe Veröffentlichung und die Spezialwerkzeuge, die Datenbanken nie sein wollten.
Das große Ganze
Was ein Team, das Confluence souverän beherrscht, von einem Team unterscheidet, das es lediglich nutzt, ist meist nicht die Zahl der bekannten Funktionen. Entscheidend ist, zu welchen Grundbausteinen es greift. Ein Team, das für alles Seiten mit Tabellen nutzt, arbeitet gegen die Plattform. Ein Team, das je nach Art des abzubildenden Inhalts zu Seiten, Datenbanken, synchronisierten Blöcken, Whiteboards oder Smart Links greift, arbeitet mit ihr.
Es lohnt sich, Datenbanken zu lernen, denn sie eröffnen eine ganz neue Art von Confluence: Strukturierte Daten sind vollwertig, Ansichten kosten kaum Aufwand, und die maßgebliche Version jedes Datensatzes liegt an genau einer Stelle. Der Nutzen zeigt sich nicht in einer einzelnen Funktion, sondern darin, dass all die kleinen Abweichungen im Wissen Ihres Teams nach und nach verschwinden.
Wenn Sie sich schon länger vorgenommen haben, Datenbanken richtig auszuprobieren, und nie die Stunde dafür gefunden haben: Diese Woche ist die richtige. Nehmen Sie die am häufigsten kopierte Tabelle in Ihrem Workspace. Überführen Sie sie. Und beobachten Sie, was passiert.